你用了好几个 AI 编程 Agent,却还在重复踩同一个坑
MEMORY · GUIDE
2026.08
换个工具,重新讲一遍?
真正拖慢开发的
是断掉的上下文
个人连续性 · 团队治理 · 架构选型
Agent Memory 选型指南
MEMORYTEAM
📦 7 Parts + Conclusion
👉 滑动
PART 01
记忆断层
工作上下文
PART 03
个人解法
自动捕获
PART ///
选型地图
按团队选择
工具越来越多,背景却要一遍遍重讲
Agent 之间存在记忆断层
你可能遇到过这样的情况:
Claude Code 刚帮你排查完一个 Bug,过两天换 Codex 写代码,同样的问题又出现了;你在 Cursor 里解释了半天项目背景,切到 OpenCode 做重构,还得重新讲一遍;团队里小李上周刚解决的环境问题,这周小王又花了半天定位,因为小李的会话记录对小王不可见。
这些重复劳动都指向同一个问题:Agent 之间存在记忆断层。
AI 编程的使用方式已经变了。过去是一个人偶尔问一次模型,现在常常是一个人同时使用多个 Agent,团队成员选择的 Agent 也各不相同。Agent 越来越强,但会话、工具和成员之间的上下文仍然彼此割裂。
这篇文章会讨论两个场景:个人同时使用多个 Coding Agent 时,怎样用最省力的方式保持上下文连续;团队共享 Agent 记忆时,又该怎样处理架构和治理问题。文末附了一张选型地图,可以直接按场景查找方案。
01
PART
Agent 记忆补的是工作上下文
CONTEXT · 工作上下文
选工具之前,先要分清 Agent Memory 在知识体系里的位置。它并不等于保存聊天记录。
现有的研发知识大致分为三层。
Git / 代码仓库保存代码事实。 它记录代码现在是什么样,却很难解释为什么这么写、哪些方案试过但没有成功,以及某个偶发问题当时是怎么定位的。
正式文档、ADR 和 Jira 保存经过确认的组织知识。 它们说明系统应该怎样工作,以及团队为什么作出某项决定。这些内容很重要,但依赖人工维护,通常只留下最终结论,容纳不了 Agent 工作过程中产生的大量中间信息。
Agent Memory 保存可复用的工作经验。 它记录做过什么、试过什么、发现了什么,以及下一次处理相关问题时应该提前知道什么。
因此,Agent Memory 不取代 Git 或正式文档。它补上的是两者之间长期缺失的工作上下文层。明确这一点之后,工具的分工就容易判断了。
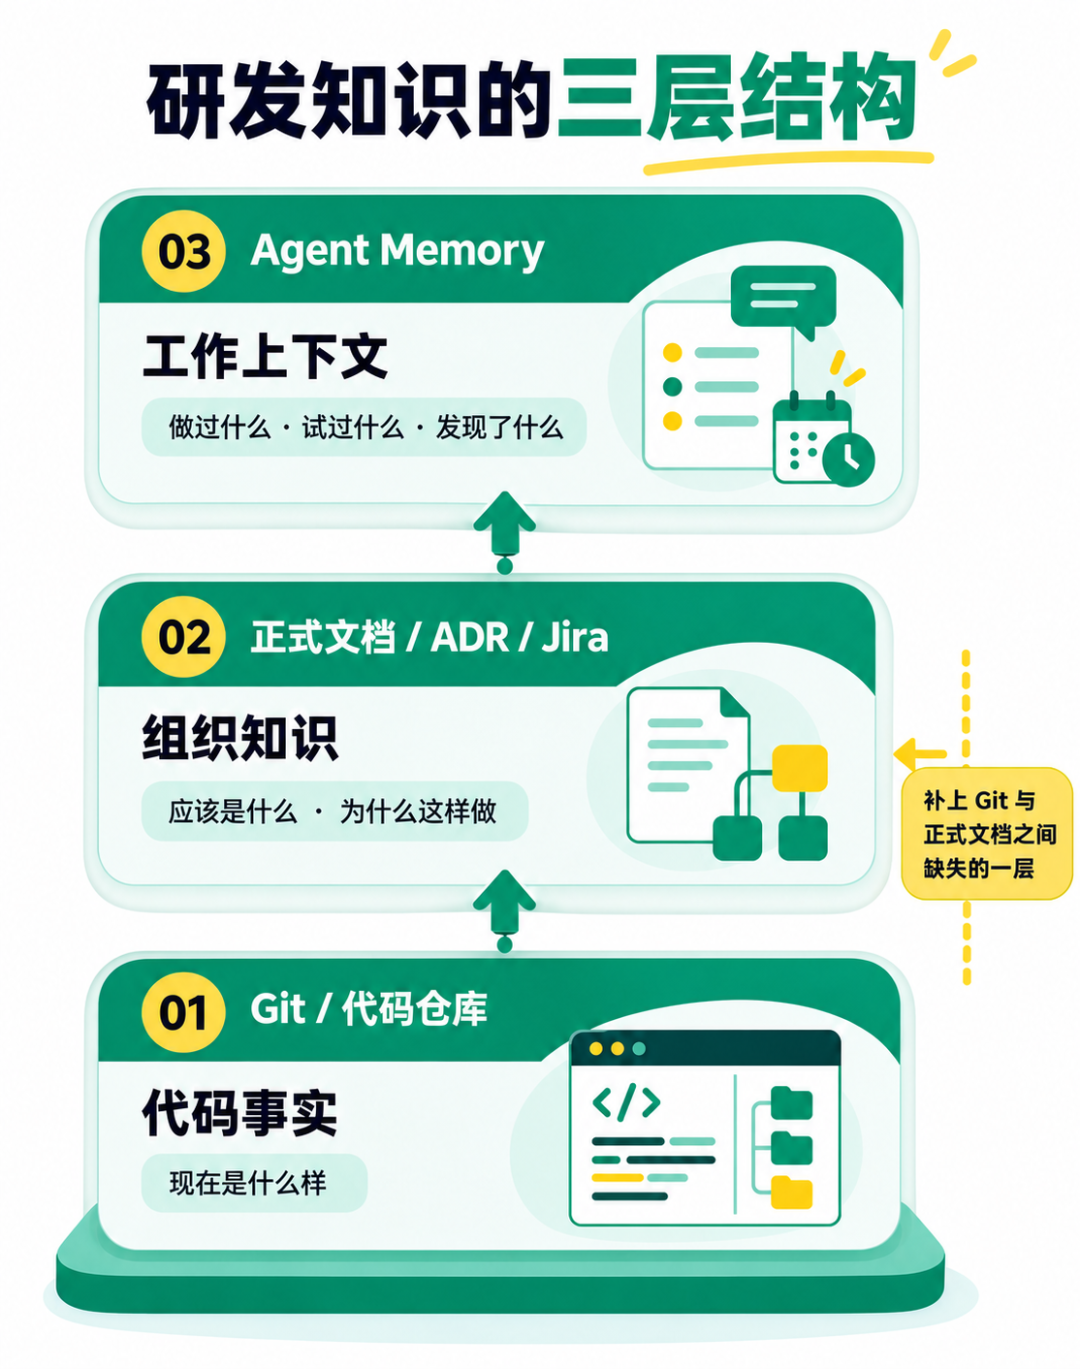
— 研发知识的三层结构
02
PART
Agent 一多,你就成了上下文搬运工
PAIN POINTS · 记忆断层
个人同时使用多个 Agent,已经是很常见的开发方式:
Claude Code
分析复杂问题、实现核心功能
Codex
并行写代码、做 Code Review
Cursor
处理日常小修改和快速问答
OpenCode
运行另一套 Agent 工作流
这些工具各有所长,信息却不会自然互通。缺少统一记忆时,每个 Agent 都要重新读取仓库、理解架构,再向你询问项目背景。支持 MCP 也不等于它们会主动把重要发现写进同一个共享位置。
最常见的问题有三类。
跨会话失忆。 昨天用 Claude Code 找到了 Bug 根因,也验证了修复方案;今天打开新会话,它已经不知道这段过程,你只能重新解释。
跨 Agent 失忆。 Claude Code 查出的根因不会自动交给 Codex,Cursor 作出的架构判断也不会进入其他 Agent。最后负责传话的还是你。
同一个坑反复踩。 环境变量、构建脚本、第三方库的已知问题,往往跟一个 Agent 解决过一次,换个 Agent 又要重来。
于是出现了一个很别扭的结果:工具越多,花在重复交代背景上的时间也越多。
03
PART
个人场景为什么优先考虑 claude-mem
PERSONAL · 个人方案
目前解决个人多 Agent 记忆问题,claude-mem 是比较顺手的选择。
它把记忆动作放在 Agent 生命周期之外,通过 Hook 自动捕获工作过程,再压缩成可复用的记忆。开发者不用反复提醒 Agent“把这件事记下来”。
流程大致如下:
TEXT
多个 Coding Agent
│
▼
自动捕获 Prompt、工具调用、修改和结果
│
▼
本地 Worker 压缩为 Observation / Summary
│
├── SQLite 保存结构化历史
├── Chroma 提供语义检索
├── MCP 提供按需搜索
└── SessionStart 自动注入近期上下文
适合进入记忆的,是以后可能再次用到的结论:
Bug 的真正根因
已尝试但无效的解决方案
某个模块采用当前结构的原因
服务端接口或历史兼容限制
环境、证书或构建流程的特殊要求
当前功能已经完成的部分
下一步计划
容易复现的 gotcha
已验证的命令和测试结果
有些内容写进去反而会降低记忆质量:
每一次普通文件读取
没有结论的短暂猜测
大量可以从 Git 重新获得的代码
已被后续结论完全替代的信息
Token、密码、证书和敏感客户数据
先统一自动记忆,再补人工知识库
刚开始可以只安装 claude-mem,让受支持的 Coding Agent 使用同一个本地数据根目录和统一 Worker。不要让每个 Agent 各自启动 Worker,同时修改同一份 SQLite 或 Chroma 数据。更稳妥的方式是让多个 Agent 通过同一个本地服务访问记忆。
TEXT
~/.claude-mem/
├── claude-mem.db
├── chroma/
├── settings.json
└── logs/
等自动记忆稳定后,再用 Basic Memory 保存经过人工确认、值得直接阅读的知识,例如架构决策、项目约束和事故复盘。
TEXT
basic-memory/
├── architecture/
├── decisions/
├── incidents/
├── constraints/
└── gotchas/
两者的职责不同:
claude-mem
自动记录详细开发过程,主要供 Agent 检索
Basic Memory
保存少量稳定知识,人和 Agent 都可以直接阅读
个人场景可以这样选:
TEXT
只想解决多个 Coding Agent 的上下文连续性
→ claude-mem
还希望长期知识可读、可编辑
→ claude-mem + Basic Memory
开发的是通用 Agent 应用,而非使用 Coding Agent
→ Hindsight 或 Mem0
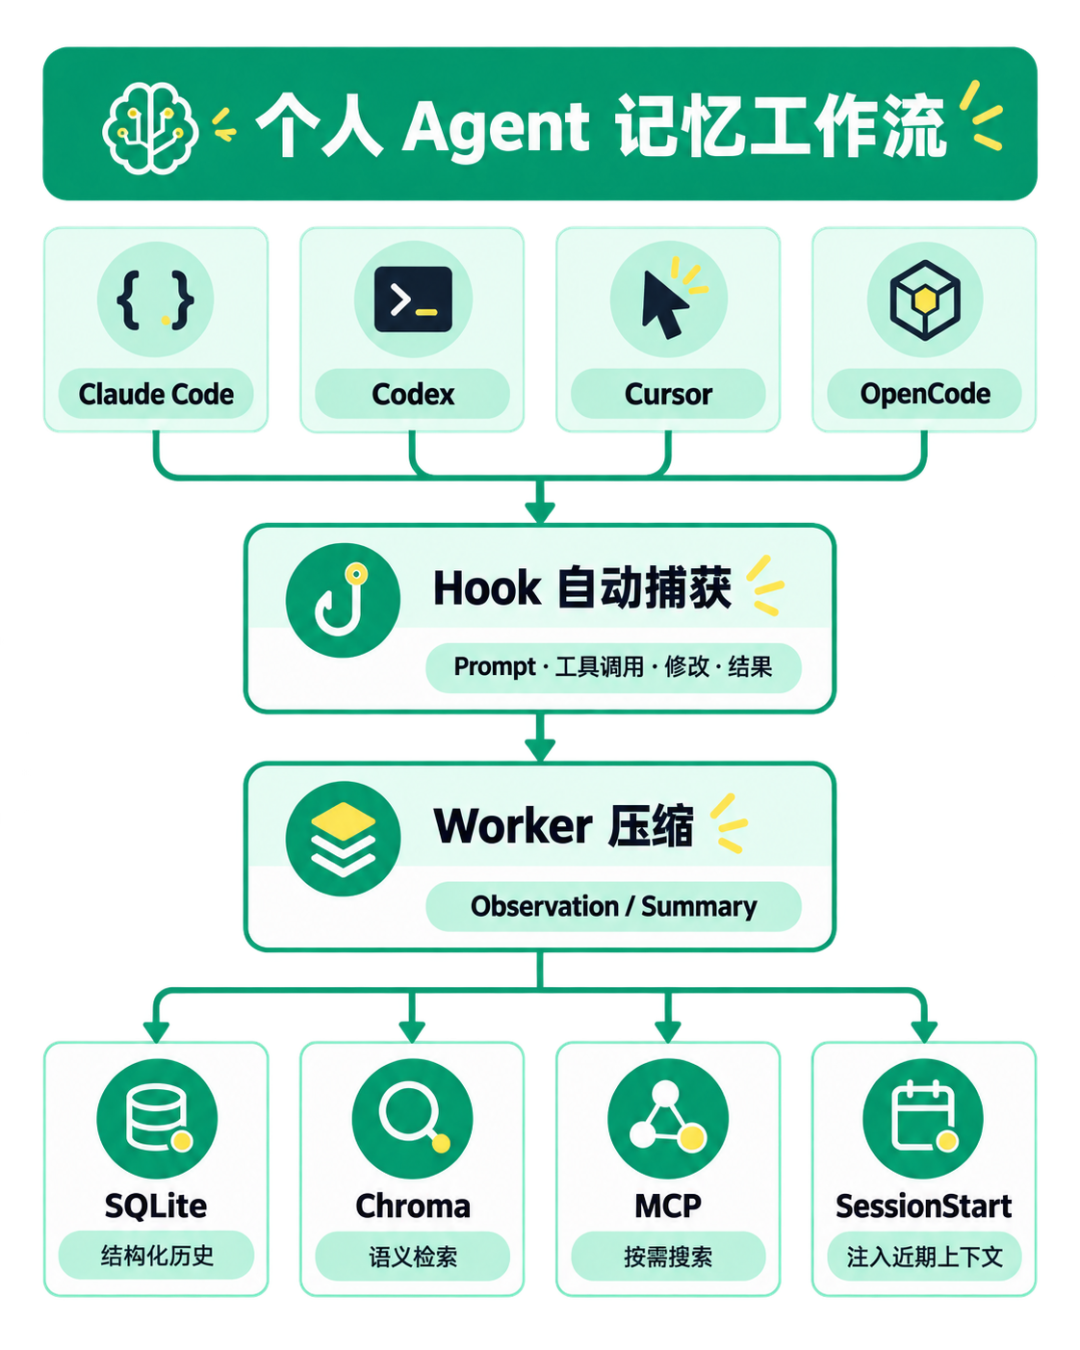
— 个人 Agent 记忆工作流
04
PART
到了团队里,难点变成治理
GOVERNANCE · 团队治理
个人使用主要关心跨会话、跨 Agent 的连续性。进入团队后,还要回答一批组织层面的问题:
每个人是否拥有独立身份
每条记忆由谁写入
不同仓库和团队如何隔离
错误记忆由谁修正
成员离职后如何撤销权限
内部代码是否会被发送给外部模型
数据怎样备份和恢复
新结论如何替代旧结论
这些边界如果没有设计好,共享记忆很快就会失控。
规模越大,信息筛选越重要。100 个人每天会产生大量工具调用,其中包括文件读取、编译过程中的临时错误、调试日志、重复修改和未经验证的猜测。全部写进长期记忆,只会让真正有价值的信息更难找到。
团队记忆至少要划分三层:
TEXT
个人记忆
仅供本人 Agent 使用,可以保留更多细节和噪声
项目共享记忆
供同一仓库的成员使用,只保存可复用结论
正式组织知识
经过人工确认,进入 ADR、README、规范或知识库
中央 Memory Server 更适合接收已经压缩、分类且保留来源的信息,而不是直接汇总所有人的完整聊天记录。
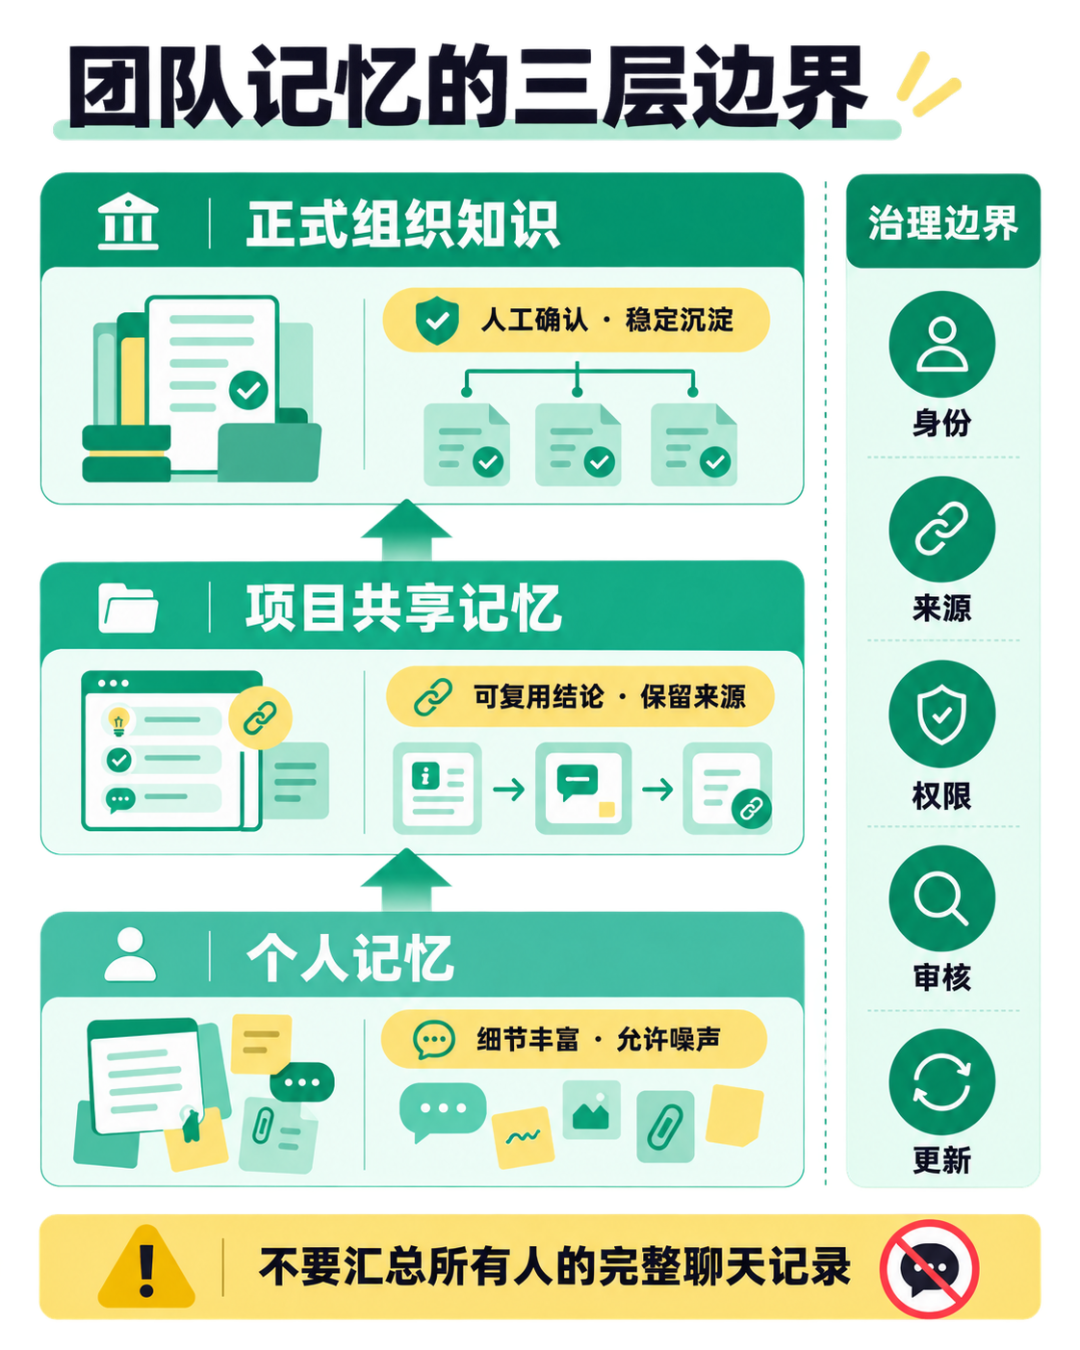
— 团队记忆的三层边界
05
PART
四种团队架构怎么选
ARCHITECTURE · 四种架构
下面四种方案按规模和复杂度排列,可以根据团队现状直接对照。
方案一:Basic Memory + Git
这是最简单的团队共享方式,几乎没有额外的软件费用。
把 Basic Memory 的 Markdown 项目放进独立 Git 仓库,或者放在代码仓库的 docs/memory 目录。每个人在本地运行 Basic Memory MCP,读写各自检出的同一批 Markdown 文件,再通过公司现有的 GitLab 或 Gitea 协作。
TEXT
成员电脑上的 Claude / Codex / Cursor
│
▼
本地 Basic Memory MCP
│
▼
共享 Markdown Git 仓库
│
Commit / Review / Merge
优点: 没有软件授权费;可以复用已有 Git 基础设施;知识可读、可评审、可回滚;权限沿用 Git;也不用向公网开放 Memory Server。
限制: 它不是实时数据库,多人修改可能产生 Git 冲突;Agent 不会自动捕获完整开发过程;团队需要制定写入规范;高频、细粒度的自动记忆并不适合这种方式。
适合: 不允许代码外传、没有专人维护 Memory 平台、想先验证长期记忆是否有价值,并且已经拥有内部 Git 服务的团队。
方案二:内网部署 Hindsight
Hindsight 把记忆作为独立的内网服务。所有 Agent 通过同一套 API 写入和检索,记忆则按 bank 组织。一个 bank 可以对应仓库、团队或用户。
TEXT
Claude Code ──┐
Codex ────────┤
Cursor ───────┤
业务 Agent ───┼── 内网 MCP / REST ── Hindsight
自研 Agent ───┘ │
└── Memory Banks
常见做法是一个仓库对应一个 bank,再按需要补充团队、用户和公共知识空间:
TEXT
repo:mobile-ios
repo:mobile-android
team:mobile-shared
user:zhangsan-private
优点: 接口中立,原生支持 MCP 和多个 bank;可以完全自托管,也能接入本地模型,减少 API 费用和代码外传风险。
部署时要注意: 默认自托管环境是开放的,正式使用前必须增加 API Key 和认证网关。它也不会自动采集 Coding Agent 的编码过程,还需要额外开发 Hook 或 Adapter。
适合: 除 Coding Agent 外还计划接入研究、产品或业务 Agent,希望所有工具通过 MCP 或 REST 共用记忆,并且有能力维护内部服务的团队。
方案三:内网部署 Mem0
Mem0 更接近一套产品化的 Memory 平台,提供 Dashboard、管理员、每用户 API Key 和请求审计日志。
TEXT
成员和 Agent
│
▼
内部 API Gateway / HTTPS
│
▼
Mem0 Server + Dashboard
│
├── 用户与 API Key
├── 请求审计
├── Memory API
└── PostgreSQL / Vector Store
与 Hindsight 相比,Mem0 的长处主要在治理:自托管版本包含 Dashboard、管理员初始化流程、每用户 API Key 和审计日志,更容易作为多个应用共用的平台能力。
相应的代价是系统和接入更复杂。Coding Agent 的工具调用仍需额外采集,本地 LLM、Embedding 和向量存储也要统一规划。
适合: 多团队、多应用,需要账号治理和审计,已经具备 API Gateway、SSO、数据库、模型网关及基础设施团队的组织。
方案四:claude-mem Server Runtime
对于以 Coding Agent 为主的团队,可以考虑 claude-mem 提供的可选 Server Runtime。它使用 PostgreSQL 保存 observation,用 Redis/BullMQ 处理异步任务,并支持 Team、Project、Actor、API Key、审计日志、REST、MCP 和 Docker Compose 部署。
它保留了编码行为的自动捕获能力,因此不必再把 claude-mem 与 Hindsight 或 Mem0 串联。
这条路线仍然较新。5~20 人的 Coding 团队可以先做内部 PoC;接近 100 人时,应先完成压测、权限评估和故障演练,再考虑把它作为主要的组织记忆平台。
建议分三步推进:
TEXT
第一阶段:选择少量项目和成员试点
第二阶段:验证并发写入、队列、检索质量和权限
第三阶段:根据结果决定是否推广到整个研发团队
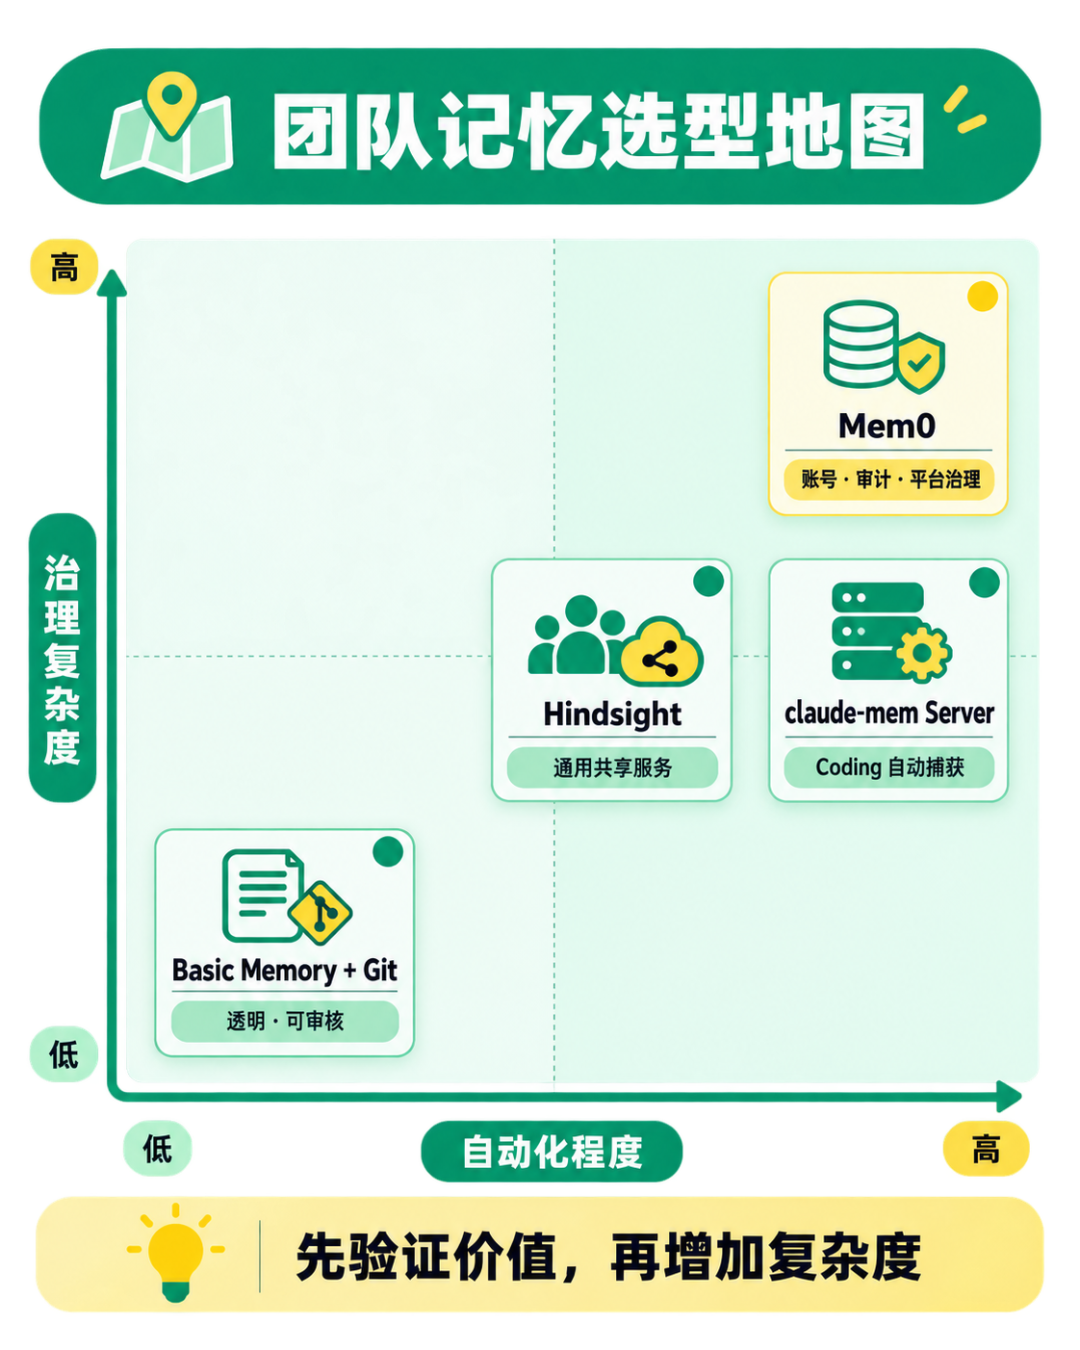
— 团队记忆选型地图
06
PART
三套更容易落地的组合
COMBINATION · 落地组合
实际落地时,单一工具通常覆盖不了所有层次。下面三套组合分别对应不同的成本和治理要求。
选择 A:低成本、低风险
TEXT
每个人本地:
claude-mem 保存个人的详细编码历史
团队共享:
Basic Memory + Git 保存经过确认的知识
正式结论:
同步进入 ADR、README、规范和 Jira
这套组合利用现有电脑和 Git 基础设施,新增软件费用为零,也几乎不需要维护中央 Memory Server。
它依靠人工筛选团队知识,无法提供自动化的实时共享;好处是过程透明,错误信息也更容易控制。
选择 B:统一的内网 Memory Server
TEXT
个人 Coding Agent
├── 本地 claude-mem 捕获个人过程
└── 只把高价值 observation 推送到中央服务
│
▼
Hindsight 内网集群
│
按团队/仓库建立 Bank
这是一套相对均衡的长期方案。claude-mem 负责自动获取编码事件,Hindsight 让不同成员、Agent 和电脑能够访问同一份记忆。
为了避免重复压缩,送入 Hindsight 的内容应当是筛选后的 observation,而非每一条原始工具事件。团队还需要保存 actor_id、agent_id、repo_id、branch、commit、memory_type、source_id、confidence 和 validated 状态等元数据。
选择 C:组织级 Memory 平台
TEXT
各类 Agent / 内部应用
│
▼
公司 API Gateway / SSO
│
▼
Mem0 Self-Hosted
├── Dashboard
├── 用户和 API Key
├── 请求审计
├── Memory API
├── PostgreSQL / Vector Store
└── 内部 LLM Gateway
有平台团队且需要账号治理和审计时,这条路线更合适。它未必能提供最顺手的 Coding Agent 自动记忆体验,但比较容易发展成多个内部产品共用的基础设施。
07
PART
“零费用”不等于没有成本
COST · 成本边界
严格来说,完全零成本几乎不存在。
使用开源版本、现有服务器、Basic Memory 与内部 Git、本地模型,以及已有的数据库和备份系统,可以把软件许可证费用降到 0、外部 API 费用降到 0,并让新增云服务器费用接近 0。
但服务器资源、GPU 或本地模型、数据库与磁盘、备份、运维时间、权限设计、记忆清理与审核、Agent 接入开发,这些成本依然存在。
因此,团队早期更值得选择的是简单方案:
TEXT
个人 claude-mem
团队 Basic Memory / Git
正式 ADR 与文档
先验证共享 Agent 记忆能否明显减少重复分析,再决定是否建设 Hindsight 或 Mem0 中央服务。
///
LAST
写在最后
DECISION MAP · 选型地图
个人开发者
优先考虑 claude-mem。个人最需要自动捕获和跨会话连续性,多租户、审计和中央服务器通常还不是刚需。如果希望重要知识可读、可修改,再补充 Basic Memory。
小型 Coding 团队
TEXT
保守路线:
每人本地使用 claude-mem
+ Basic Memory / Git 共享精选知识
自动化路线:
小范围试点 claude-mem Server Runtime
几十人到 100 人以内的团队
| 团队目标
|
推荐方案
| | --- | --- | |
接近零新增费用,要求透明、可审核
|
Basic Memory + Git
| |
建立跨 Agent 的通用内网记忆
|
Hindsight Self-Hosted
| |
建立带账号、API Key、Dashboard 和审计的平台
|
Mem0 Self-Hosted
| |
团队高度聚焦 Coding Agent,重视自动捕获
|
先试点 claude-mem Server,再决定是否扩展
|
四个工具可以简单理解为:
TEXT
claude-mem → 个人 Coding Agent 的自动记忆
Hindsight → 中立的内网共享 Memory Server
Mem0 → 具备管理和治理能力的组织级 Memory 平台
Basic Memory → 人和 Agent 都能阅读、可由 Git 管理的长期知识库
可持续的方案需要明确分工:claude-mem 保存个人工作过程,Hindsight 或 Mem0 提供团队共享服务,Basic Memory 与 ADR 保存人工确认的长期知识,Git 记录最终的代码事实。
每一层只承担自己擅长的职责,Agent 记忆才不会从解决问题的工具,变成新的信息负担。
我是Yakir。一名原生移动端开发工程师。擅长将想法落地为移动端应用。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
赞
点赞
看
在看
享
转发
THANKS FOR READING
保留公众号的原始配色与排版。