---
id: magpie-continuous-iteration
title: 一天上百次提交,Magpie 是怎么持续迭代的?
summary: 从 Magpie 的高频提交出发,看 Agent 如何处理反馈、验证改动,并把一次修复变成下一次维护的规则。
tags:
- AI
- 软件工程
publishedAt: 2026-11-05T06:56:17.250Z
updatedAt: 2026-11-05T06:56:17.250Z
writtenAt: 2026-10-15
originalPublishedAt: 2026-10-16T11:41:00+08:00
wechatUrl: https://mp.weixin.qq.com/s/V7PKNDYJLWqusarRhNW4nA
url: https://wuyanji.datiaomao.com/articles/magpie-continuous-iteration/
markdownUrl: https://wuyanji.datiaomao.com/articles/magpie-continuous-iteration/index.md
---
工程实践 · 案例手记2026年10月
一天上百次提交,Magpie 是怎么持续迭代的?
高频提交背后的验证、合并与经验回流
一个Github上的开源仓库,一天192次提交,18次发布。
这就是 Magpie 在2026年10月8日产生的数据。
假设让你来处理,一天上百个提交,你能看得过来吗?
Magpie 的维护者 yetone,已经把代码编写、审查、合并和发布中的大量工作交给 Agent。人仍然参与产品判断和部分界面交互的处理,但不再逐条安排所有维护动作。
2026年10月12日,WquGuru发表了一篇分析,沿着 Magpie 的提交历史和工程文档,拆解这套工作方式。次日,yetone 又公开了维护提示词,补充了任务如何持续进入系统的细节。
他把写代码、处理反馈和决定能否交付连成了一套可以反复运行的流程。即使在AI圈中,Loop已经人尽皆知,但是好的Loop例子仍然少见。
这套流程中,我觉得最关键的一个点是: 任务可以并行推进,每次进入项目的修改却必须留下可检查的证据;做过的工作,还要能减少下一次重新判断的成本。
今天我们就来拆解一下他的方法。
01
PART
任务从哪里来
PARALLEL TASKS
在具体说明他的操作之前,我们先介绍一下 Magpie。
Magpie 是 yetone 维护的本地大模型网关,处在编程 Agent 和模型供应商之间。用户可以统一管理模型、账号和路由,比如让 Claude Code 使用 Kimi,让 Codex 使用 DeepSeek,也可以通过路由组在额度耗尽后切换账号或模型。
Magpie 本身并不是一个专门展示自动开发能力的框架。但自动维护,是这个产品的开发方法。
这样的产品,维护难点在具体场景下。同一个报错,换一个操作系统、一个模型供应商或者一种订阅套餐,结果都可能不一样。用户用图形界面还是命令行,也可能影响问题能否出现。你在自己的机器上修好了一处,不代表提交问题的人已经修复。
按 WquGuru 原文约19天的统计窗口,Magpie 当时已有2,862次提交、合并了383个社区 PR,另有1,204个 Tag、9,474颗 Star。
提交和贡献持续涌入,yetone就必须解决一个调度问题:哪些事情可以分头干,哪些事情必须等结果。
他公开的工作方式,是在 Claude Code 里并行运行三个
/loop。
第一个循环处理 GitHub 和 Discord。它从 Issue、社区 PR 和讨论中找值得做的任务。处理 PR 时,要把代码拉下来实际运行、验证,再决定能否合并。
第二个循环处理 X(Twitter) 上的反馈。相关且有价值的问题进入开发流程,发布后再回复原帖。
第三个循环检查代码和维护过程。它关注难以维护的实现、潜在有害改动,以及不该合并的 PR、验证不足的修改,再把这些发现整理成后续 Agent 能读到的经验。
这几个入口分开后,用户反馈、社区贡献的审查和内部复盘可以同时进行。他不用等做完一件事,才去关注下一件。
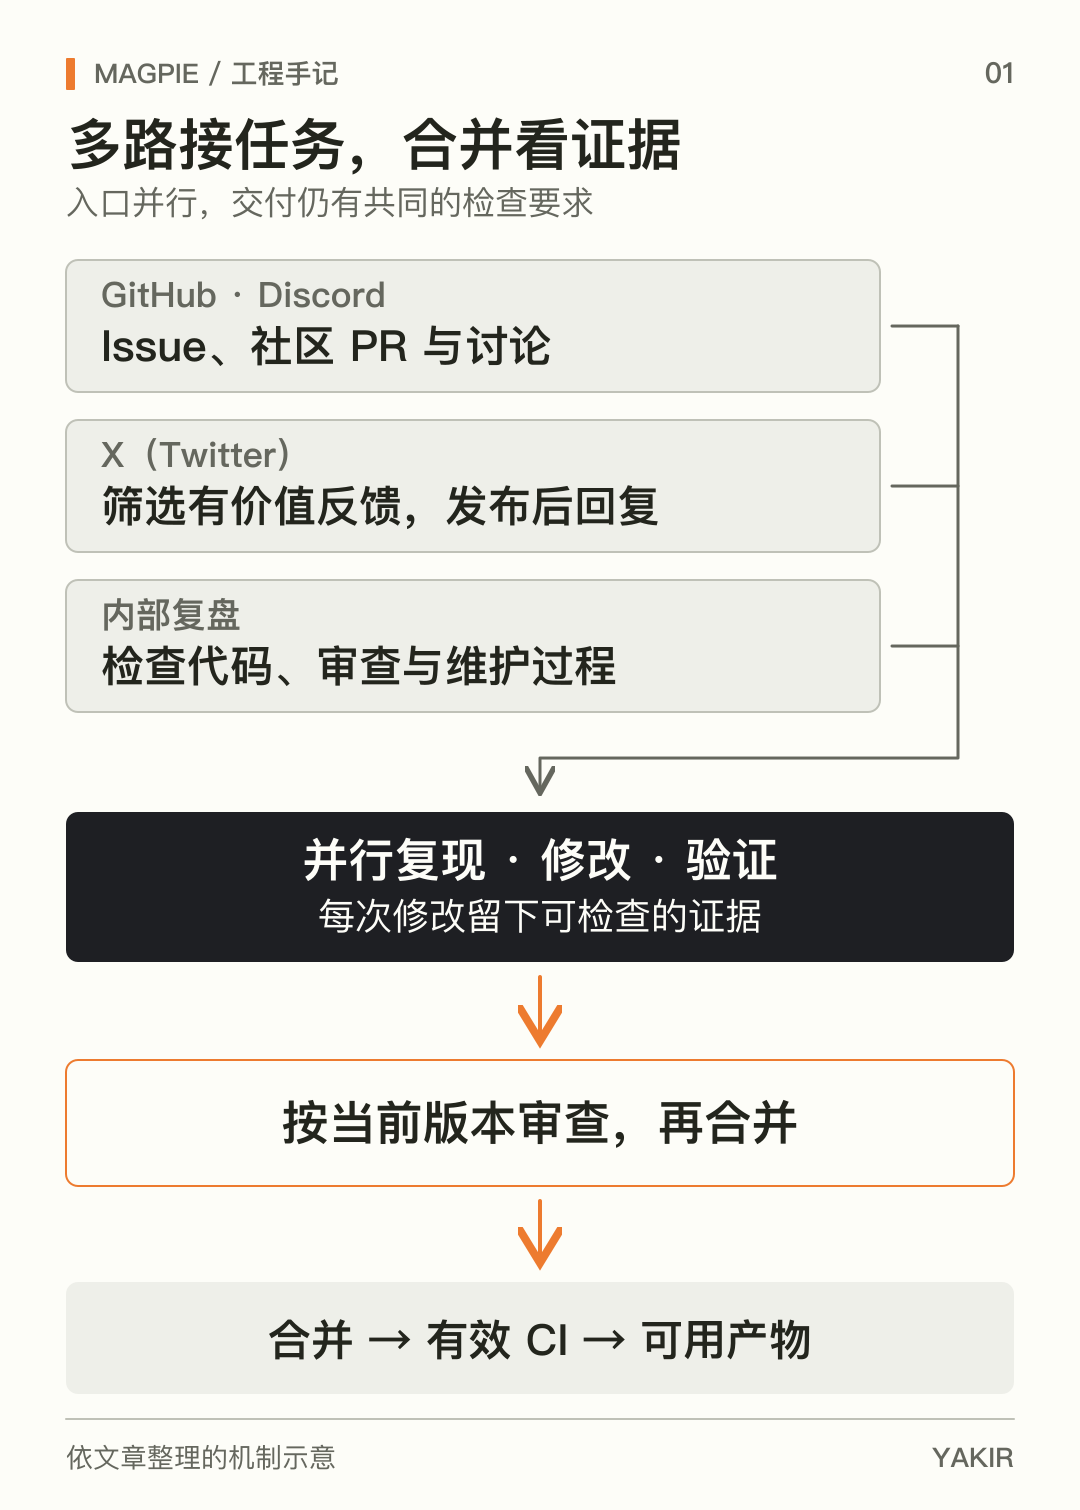
图一|三个任务入口并行推进,合并和发布遵循共同的检查要求。
任务可以并行开发,到合并时需要按什么标准处理呢?这就要看几个循环共同遵守的要求。
02
PART
把上下文留在项目里
PROJECT KNOWLEDGE
如果每接一个新任务,你都要重新向 Agent 解释项目结构、开发规范和此前踩过的坑,那任务一多,你的时间就又花在了反复交代要求上。
Magpie 把这部分上下文放进了项目文件。
AGENTS.md 是入口。改某个子系统,应该先看什么设计文档;审查代码,需要遵守什么规范;接手社区贡献,要检查哪些事项;动手之前,近期教训在哪里。这份文件负责把 Agent 引领到正确的方向。
LESSONS.md
保存持续变化的经验。哪里返工了,哪次合并有问题,什么验证没有做到位,都可以在这里留下记录。
相对稳定的要求,则进入 docs/code-standards.md,成为开发、审查和发布时需要对照的标准。
换一个任务、开一轮新对话,这些依据仍然能找到,不必每次重新交代。
不过,存一份经验,并不意味着经验就会起作用。复盘写得再认真,如果没有改变后续任务的要求,同样的问题仍然可能再来一遍。
在 Magpie 里,一条 Lesson 要写出规则、原因,以及相关的提交或 Issue。有些还保留做对的案例,让下一位 Agent 看明白当时哪里出了问题,遇到类似场景应该怎么处理。
比如 WquGuru 提到的 [#834](javascript:;),多次返工的原因,是每轮只修了截图里某个 Agent 的表现,没有覆盖报告者真正使用的完整场景。提炼出来的要求就很具体:先按报告者的供应商、套餐、Agent 和操作界面复现,再宣布修复。
项目还追踪教训是否反复出现。同一条教训在三个不同日期的复盘中出现,就会提升到代码规范,进入后续审查的检查范围。
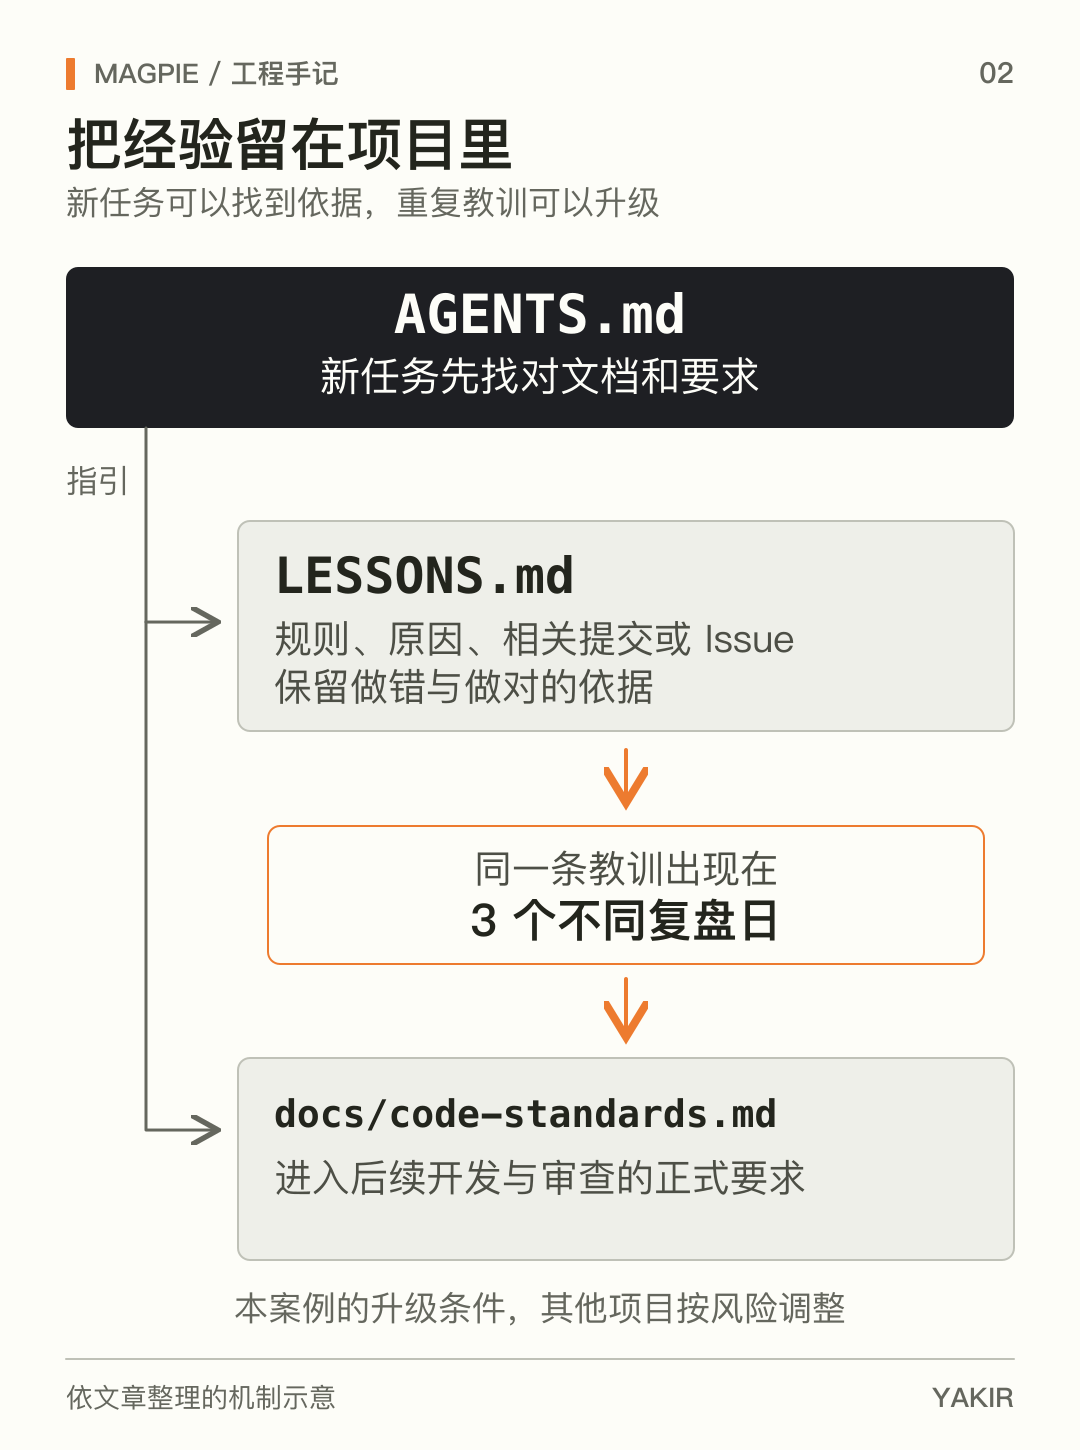
图二|入口文档负责指引,教训记录积累经验,稳定要求进入正式规范。
一次调查如果只能服务当下那个任务,后面的 Agent 还要从头理解一遍。把局部修复的经验写成可执行的规则,后续 Agent 就有机会接着用,少做一些重复调查。
其他项目不必机械照搬“三次”。涉及数据损毁或权限失守的问题,第一次就可能需要升级。关键是让经验能有升级正式要求的机会。
03
PART
测试怎样证明有效
VERIFY THE VERIFICATION
合并之前,一份 fix 怎样证明自己已经做好了?
假设一个 PR 声称修复了“设置保存后重启丢失”。Agent 改了代码,写了测试,测试也通过了。
这就能放心合并了吗?还得看看,这个测试能不能识别原来的错误。
因为实现和测试可能同时理解错需求,而且恰好互相证明。你看到验证成功,其实用户的路径和场景跟你都不同。
Magpie 使用的办法叫回退测试,也就是 Red Check:暂时恢复旧实现,再运行新写的测试。旧实现必须因为目标行为不对而失败,编译失败、环境缺失或者测试被跳过,都不能做数。
还是保存设置那个例子。如果恢复旧代码以后,新测试照样通过,那就说明这个测试没有抓住原来的缺陷。这个问题要在合并之前暴露出来。
PR [#1339](javascript:;) 合并前评论还记录了进一步的 Break Check:故意让一个关键判断始终返回真,看看测试能否抓住另一类错误。评论列出了测试、失败行为,以及恢复修改后的结果。
后续维护者能沿着记录查到,测试针对什么错误,以及为什么能相信它能有效。
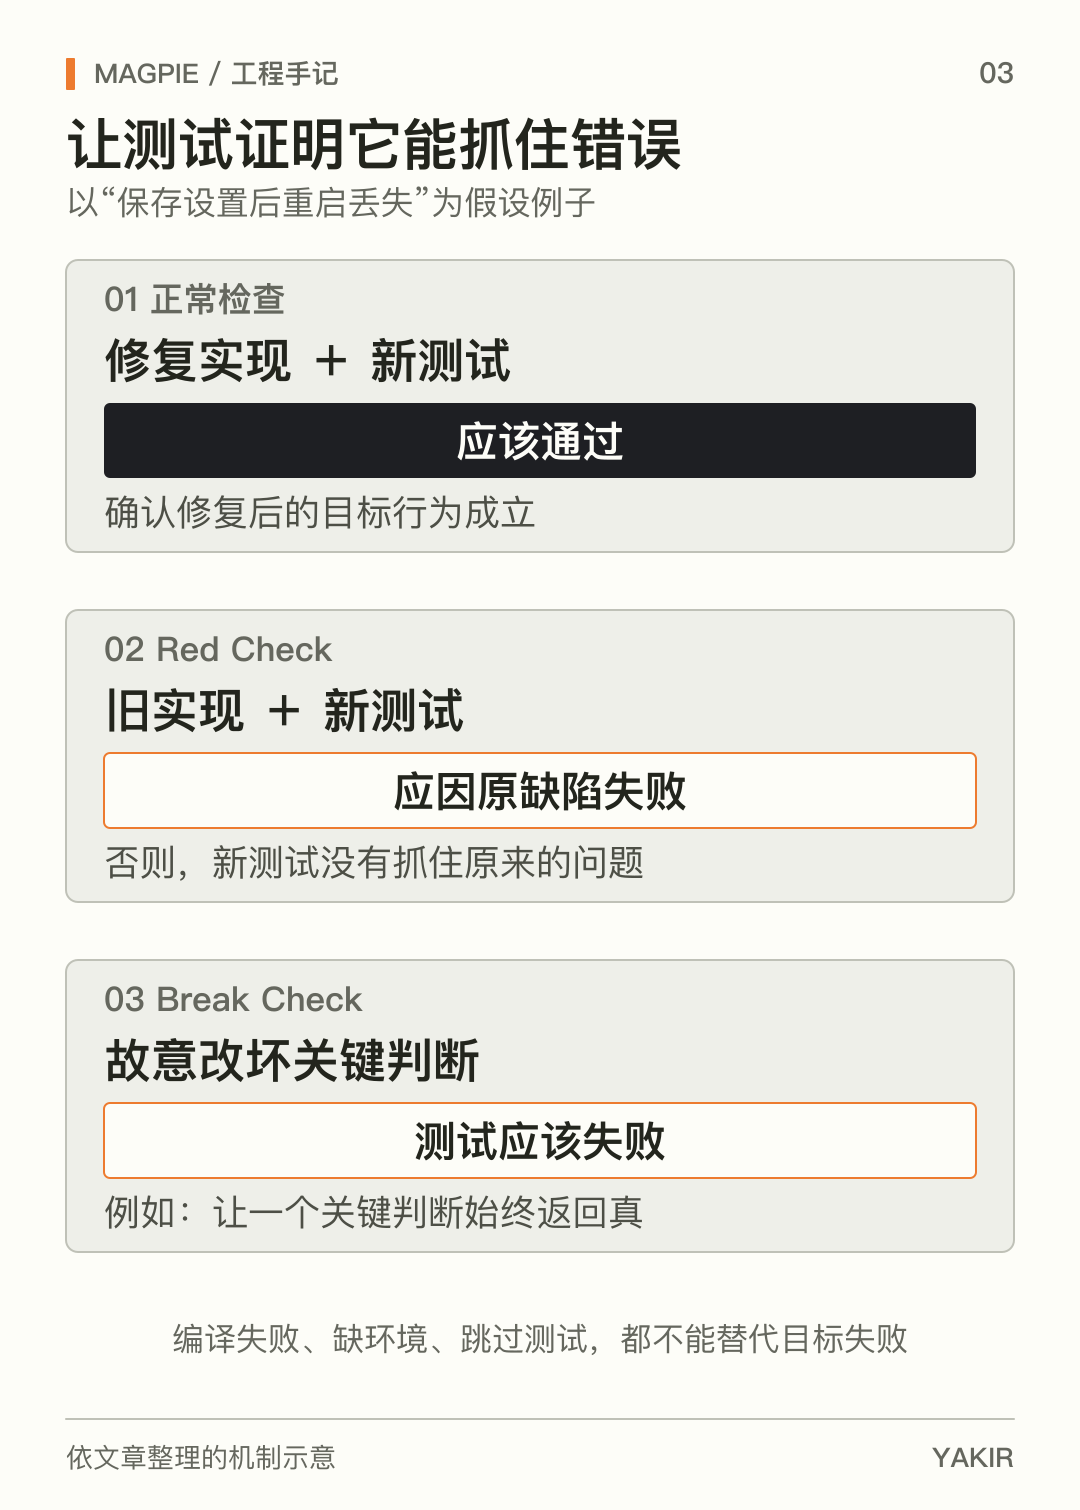
图三|通过旧实现和故意改坏的实现,检查测试是否有辨别错误的能力。
但测试有辨别力,还得放在正确的场景里运行。
对于 Magpie 这样的网关,理想化的模拟响应很容易漏掉真实使用中的差异。所以项目规范要求,在条件允许时,用真实账号或 Key、真实配置格式和供应商返回验证;平台特有的问题,在对应平台检查,并使用隔离环境,避免扰动正在使用的配置。
离线回归测试负责让检查可重复,真实集成检查负责确认实际使用能成立。两种证据各有用途。
没有做完的检查,也要明确记下来。PR [#1339](javascript:;) 的评论就写了没有运行真实的 dsh 桌面应用。
这让下一位接手者知道,哪部分已有证据,哪部分还需要补充。必需检查缺失,就保留未完成状态,或者明确缩小交付范围。
任务一多,很难单凭记忆分清每次到底验证到了哪里,这些记录就派上了用场。
04
PART
合并与发布分别把关
MERGE & RELEASE
你审查一个 PR 的时候,别人又向它推送了新代码。你刚才看到的检查结果,还能不能用来批准现在的版本?
代码已经变了,当然需要重新确认。
Magpie 要求记录审查过的提交,并通过 \--match-head-commit 限制合并。审查期间 PR 如果有新的 push,就不能沿用旧结论直接合进去。规范还要求基于当前主分支验证合并结果。
审查记录得说清楚:哪份修改,基于哪个主分支,经过哪些检查,可以进入项目。
不同任务最后都要合进同一个产品。它们单独看可能没问题,但合在一起的状态其实也需要验证。
提交可以频繁发生,发布却要等有效的 CI 通过结果。被取消的运行不能算通过,Tag 也只是一枚版本标记,后面还得确认构建成功、可用产物确实交付给用户。
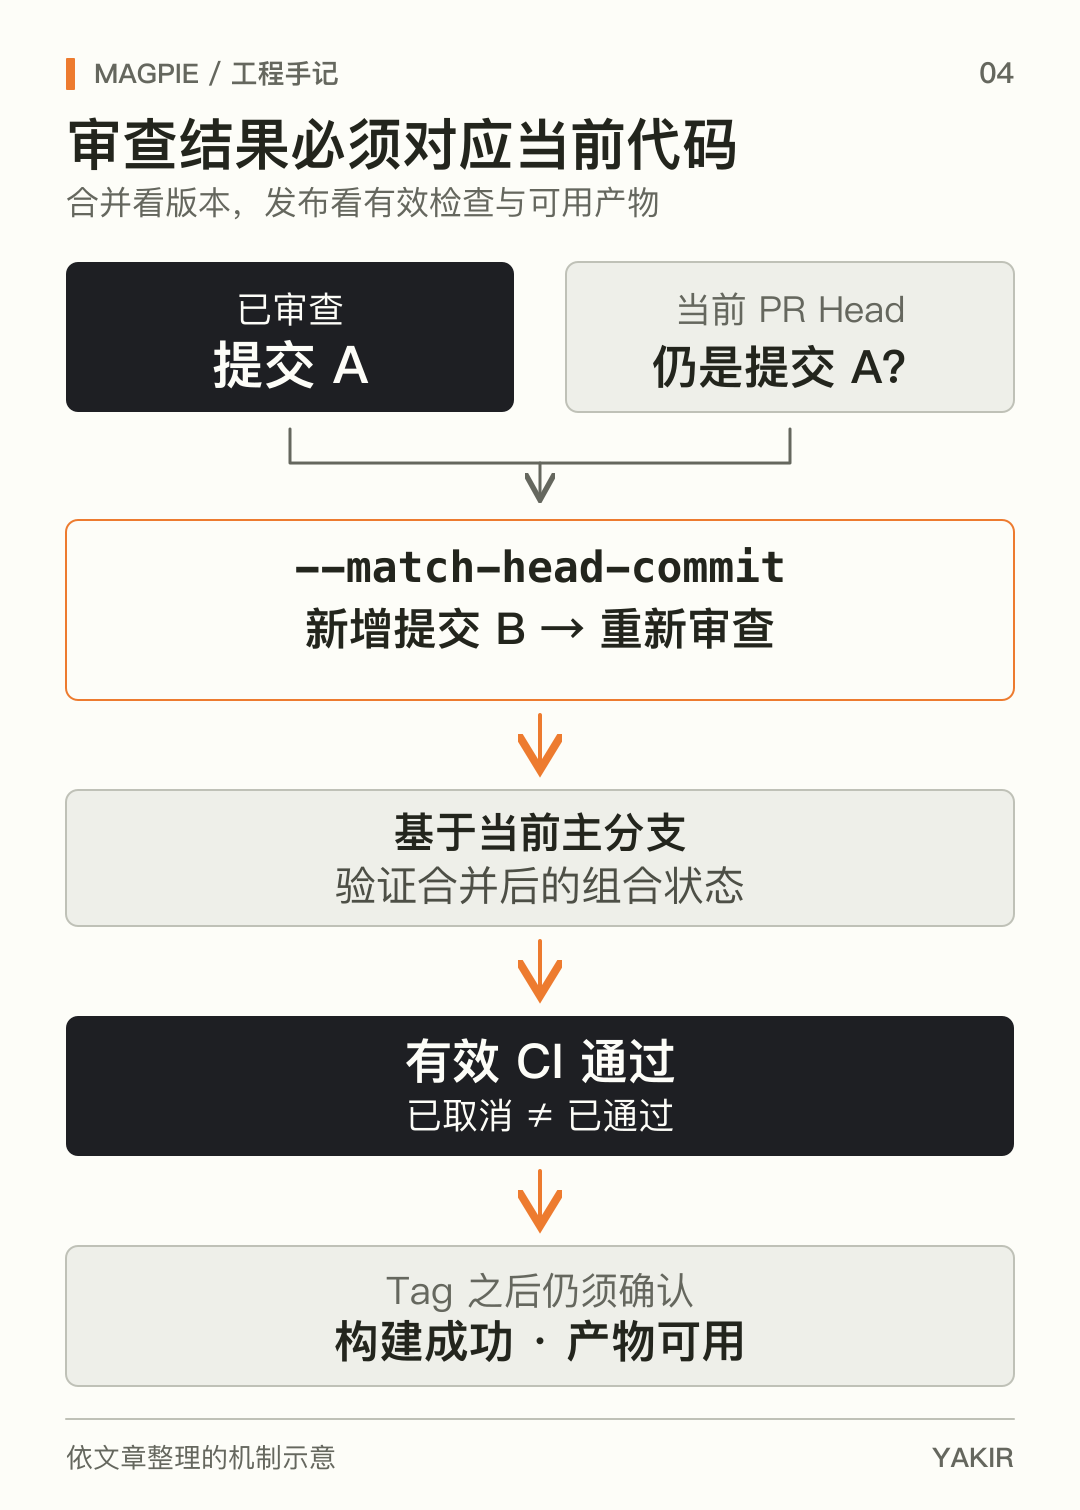
图四|审查证据绑定当前代码,发布还要确认 CI、构建和实际产物。
这条要求有实际来由。WquGuru 回溯到10月5日,当天约220次提交、近170次发版,其中约40次在修当天或前一天刚发布的内容。频繁 push 还不断取消正在运行的 CI,有些失败就没有及时进入维护者视野。10月6日凌晨引入的 LESSONS.md,开始把这些问题转成后续发布必须遵守的要求。
后来日发布数量从168降到42、15,之后一段时间大致在15到26之间。
项目依然可以一天产生大量提交。各项工作可以尽量并行,能不能交付则要看对应的检查结果。
05
PART
人负责哪些判断
HUMAN JUDGMENT
yetone 仍然处理部分 UI、UX 问题,也会给出具体产品反馈。工程规范还保护已经明确做出的产品决策,不因为新 PR 看起来不错,就随意推翻原有选择。潜在有害改动也需要维护者介入。
用户提出建议、社区提交代码,都值得认真查看,但“有人想做”和“这个产品应该做”之间,需要抉择。
把执行交给 Agent 以后,人的精力可以更多地放在这里:哪些问题值得解决,哪些选择应该坚持,这次交付需要到什么程度。
这套方法也有社区的积累。WquGuru 追溯到,子系统文档和部分审查规则来自 Junjie Zhou 的贡献。人把理解写进项目,Agent 在执行中补充新的经验,后续任务再继续使用这些积累。
规范写进文档,仍然可能被漏读、误解或绕过。已经能检测的问题,最好继续写成回归测试、静态检查或 CI 阻断条件;需要产品判断的部分,则保留人工审查。
06
PART
从一条任务路径开始
START WITH ONE TASK
这个方法放在我们自己的项目中,要怎么做?可以先把一条任务路径做完整。
找一个稳定、可复现的 Bug,开始之前写清楚完成条件。让 Agent 复现、修改,再拿验证结果回来;不通过就继续修,缺少关键环境就把缺口报告出来。最后留下测试命令、结果、对应提交和没有执行的项目。
这条路径能可靠地走完,再增加任务来源和并行会话。
你可以先只处理 GitHub Issue,也可以先只检查某个子系统。没必要一开始就同时监听多个社区,把自动合并和自动发布一并打开。入口增加以后,每条任务都需要清楚的负责人,多个会话也需要隔离工作区,避免互相覆盖。
任务结束后,还要看哪些经验能留下来。
如果这次修复暴露了一个此前没考虑到的使用场景,就把它写进验收条件;如果同类入口容易漏,就补上覆盖它们的检查;如果连续返工来自同一个误解,就把那个误解说明白,必要时提升到正式规范。
定期回看返工记录,每次提炼少量有证据、能执行的要求,让这次任务的结果也能帮下一次少走弯路。
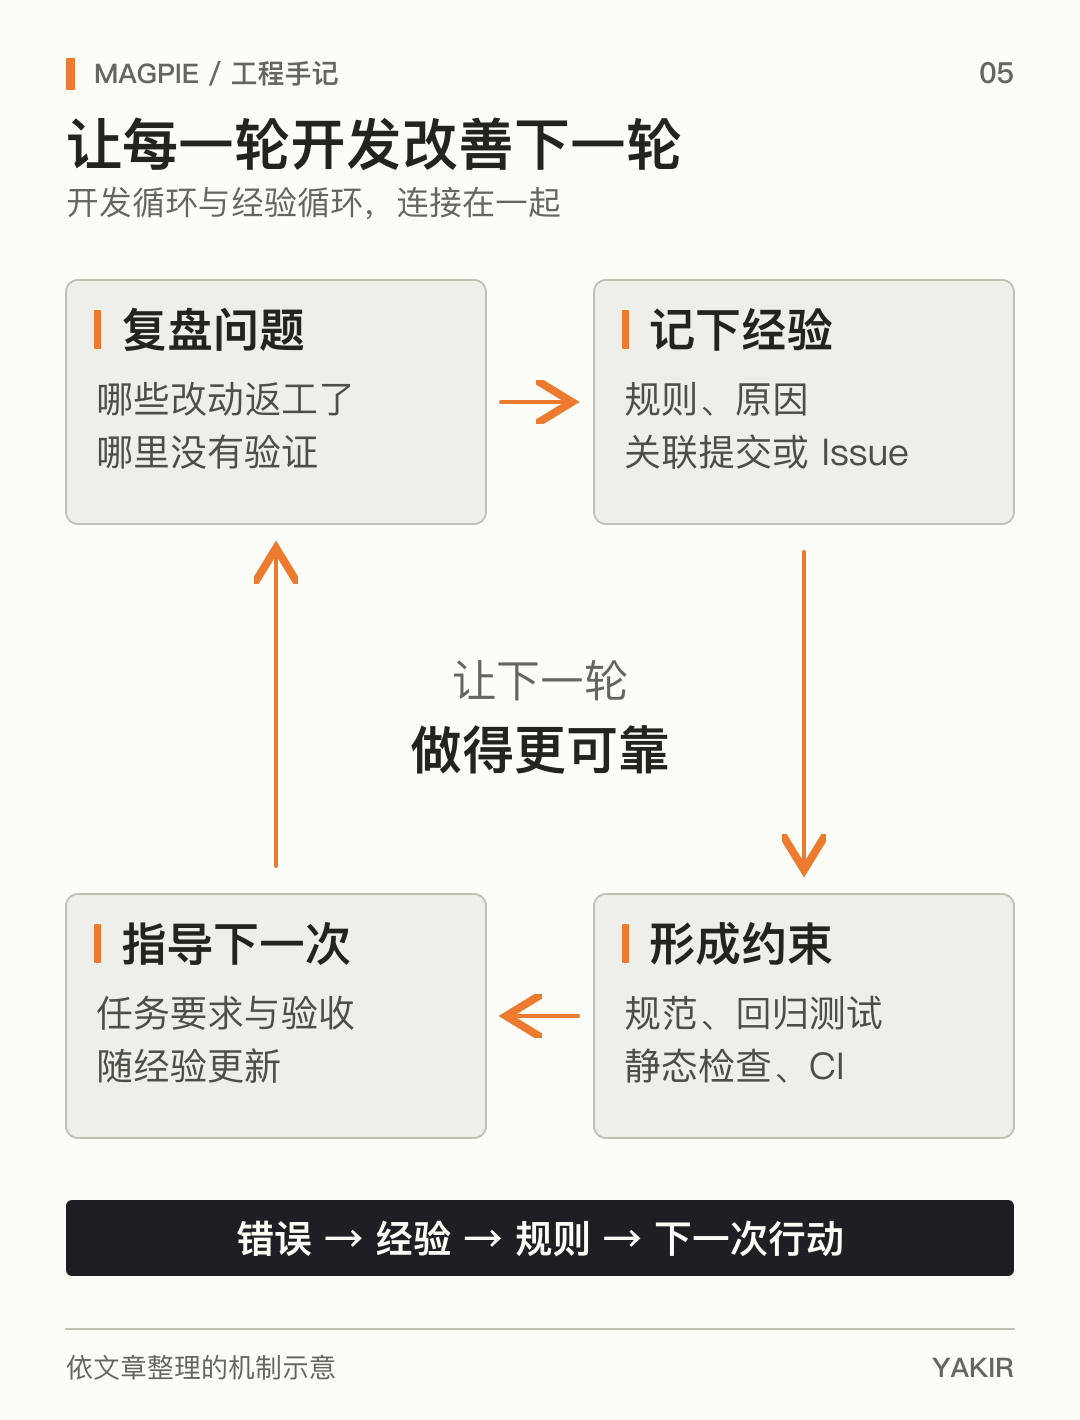
图五|错误、经验和规则连接到下一次开发,形成持续改善的反馈。
循环本身也要知道何时停。需要产品决策,就交给人;连续修复没有进展,或者超过任务预算,就停止无限重试。这些是借鉴案例后的落地建议,并不是 Magpie 已公开配置的完整复述。
最后,观察那些能说明交付质量的信号:同类问题是否减少,Issue 是否反复重开,一次验收通过率怎样,平均还要返工几轮。提交数量可以说明系统很忙,这些信号才能帮你判断它是否越做越好。
一次工作除了交付代码,还应当留下下一次可以继续使用的判断依据。
这些依据积累下来,新任务进来时,维护者就不必每次从头讲起。Agent 能沿用项目里的规则、测试和证据,维护者也就有机会把精力留给需要自己判断的事。
///
END
让每一轮开发留下依据
THE LEARNING LOOP
回头看 Magpie,最值得学习的不是三个 /loop,也不是一天能完成多少次提交,而是它让每一次开发都能为下一次留下点依据。
如果 Agent 只是不断接收任务、修改代码、发布版本,那只是把开发速度提高了。只有当错误能够转化为经验,经验进一步变成规则,规则又能影响下一次开发时,Loop 才真正形成了闭环。
一个好的 Loop,不只是让 AI 持续工作,更重要的是让整个开发过程越做越好。
我是 Yakir,移动端原生工程师,努力学AI、玩AI。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING