---
id: transformer-architecture
title: Transformer 架构深度解析
summary: 从注意力机制出发,梳理 Transformer 的组成部分与模型处理序列的方式。
tags:
- AI
- Transformer
publishedAt: 2026-11-05T06:56:17.250Z
updatedAt: 2026-11-05T06:56:17.250Z
originalPublishedAt: 2023-11-03T11:12:00+08:00
wechatUrl: https://mp.weixin.qq.com/s/GdwrDfad1EWwhRTUquQDxg
url: https://wuyanji.datiaomao.com/articles/transformer-architecture/
markdownUrl: https://wuyanji.datiaomao.com/articles/transformer-architecture/index.md
---
# Transformer 模型:革命性的自然语言处理技术
在自然语言处理领域,Transformer 模型标志着一次革命性的突破,摒弃了传统的循环神经网络(RNN)或长短时记忆网络(LSTM)结构,引入了全新的注意力机制,使得文本数据的处理更为高效。与传统模型不同的是,Transformer 摆脱了序列上的循环依赖,使其更容易并行化,训练速度更快。
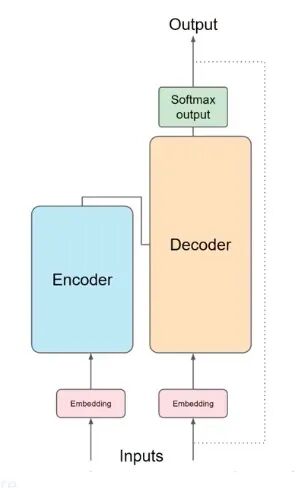
Transformer 架构图
## 主要组成部分
Transformer 模型主要由两部分组成:编码器(Encoder)和解码器(Decoder)。其工作流程可以简洁地概括为以下几步:
1. Embedding(嵌入):将输入的文本信息分割为 tokens,并将这些 tokens 转换为向量表示。这一过程称为 Embedding。
2. 编码器(Encoder):编码器采用了自注意力机制和前馈神经网络,将输入向量进行编码,得到编码器上下文表示。这些上下文表示将被传递给解码器,用于后续的生成过程。
3. 解码器(Decoder):与输入类似,解码器也经过 Embedding,将文本转换为向量。解码器将整合编码器的上下文表示和自身已生成的文本向量,进行推断。
4. 输出生成:解码器的最终输出经过线性变换和 Softmax 函数,转换为生成词汇表中每个 token 的概率分布,用于生成最终的输出序列。
通过这简洁而高效的流程,Transformer 模型在自然语言处理任务中取得了卓越的成绩,为文本处理领域带来了全新的可能性。
# 深入理解Transformer架构
了解为什么 Transformer 成为当前大型模型的主流框架,仅仅掌握它的简单工作流程是远远不够的。接下来,我们将深入探讨 Transformer 架构的每个组成部分,对其进行详细剖析。请看下图: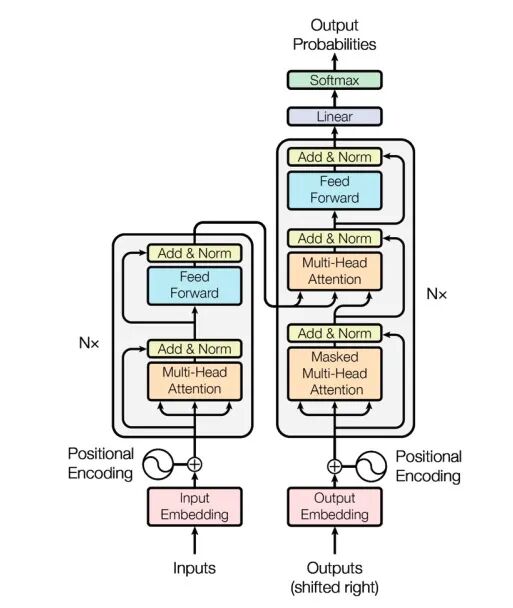
## 编码器
### 输入嵌入(Input Embedding)
在 Transformer 模型中,输入信息(通常为文本数据)在进入网络之前会经过嵌入层(Embedding Layer)的处理。嵌入层的主要任务是将输入的离散化数据,如单词或字符,转换为高维稠密的实数向量。
嵌入层的操作步骤如下:
1. 词汇表建立(Vocabulary Establishment):针对输入文本的所有不同单词(或字符,或其他离散单位),建立一个词汇表(Vocabulary)。该词汇表包含了所有可能的单词,并为每个单词分配一个唯一的整数标识符。例如,对于句子“吃饭了吗”,每个字可能被编码成一个数字(如【1234,2234,6789,6734】)。
2. 嵌入矩阵初始化(Embedding Matrix Initialization):为词汇表中的每个单词随机初始化一个实数向量。这些向量被组织成一个嵌入矩阵(Embedding Matrix)。嵌入矩阵的行数通常等于词汇表中的单词数量,列数则等于嵌入向量的维度(这个维度通常是一个超参数,如256或512)。每一行对应词汇表中一个单词的嵌入向量。
3. 查找嵌入向量(Lookup Embedding Vectors):对于输入文本中的每个单词,使用它在词汇表中的标识符作为索引,从嵌入矩阵中查找相应的嵌入向量。这个查找过程将输入的离散化数据映射为连续实数空间中的嵌入向量。
嵌入层的目的是将离散化的输入数据转换为密集的连续向量,使得模型能够更好地理解单词或字符之间的语义关系。这些嵌入向量包含了一定的语义信息,使得模型能够更好地捕捉输入文本的语义和语法特征,为后续处理提供了更有意义的输入。
### 位置编码(Positional Encoding)
在将输入信息传递给解码器之前,需要为信息添加位置编码。在 Transformer 中,没有像循环神经网络(RNN)或卷积神经网络(CNN)中那样的显式顺序信息。为了引入词的顺序信息,我们在输入嵌入中添加位置编码。
位置编码是一组特殊的向量,其维度与输入嵌入的维度相同。这些向量被设计为在不同位置上具有不同的数值,以提供词的顺序信息。每个位置都有一个唯一的位置编码,包含了该位置的信息,帮助模型理解词的相对位置关系。
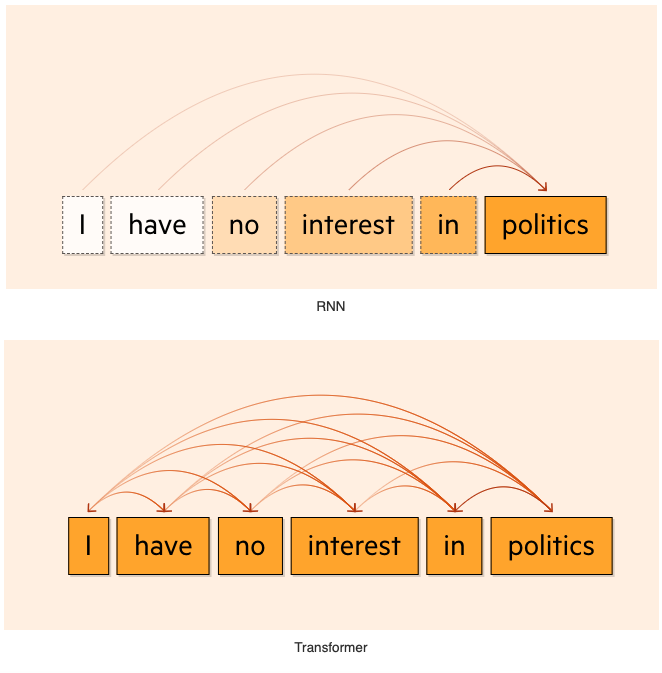
> 在传统的循环神经网络(RNN)中,序列数据是按顺序逐个处理的,每个时间步的输入依赖于上一个时间步的输出。RNN能够捕捉到序列数据中的顺序信息,但计算是顺序的,难以并行化,导致处理长序列时效率低,容易受梯度消失或梯度爆炸问题的影响。 相比之下,Transformer模型使用自注意力机制来处理序列数据,不依赖于固定的顺序。然而,为了使模型理解输入序列中的相对位置信息,需要引入位置编码。位置编码的引入允许Transformer模型在没有固定顺序的情况下处理序列数据,并捕捉到序列中的位置信息。 Transformer模型的自注意力机制和位置编码的结合使其能够处理长序列,具有并行计算优势,特别适用于需要考虑长距离依赖关系的任务。此外,Transformer模型更容易进行并行化训练,提高了训练效率。
### 编码器的注意力机制(Attention Mechanism)
接下来,我们深入研究编码器的注意力机制,编码器的任务是将输入转换为上下文表示,这些表示将用于解码器的生成过程。通常,编码器由多个相同结构的叠加编码器层组成。每个编码器层内部结构包含多头自注意力机制、前馈神经网络和残差连接与层归一化。
#### 多头自注意力机制(Multi-Head Self-Attention)
在Transformer模型的自注意力机制中,每个输入序列的词向量都可以与序列中的其他词向量进行比较,并分配一个权重。这些权重决定了在生成上下文表示时,每个词对最终表示的贡献程度。
自注意力机制允许模型在处理输入时,根据输入的不同部分分配不同的"注意力权重"。这样,模型能够更集中地关注对当前任务最重要的部分。这种集中关注的过程被称为"注意力集中",即模型在处理输入时集中精力关注特定部分,减少对其他部分的关注。
这种机制的关键在于,模型可以根据整个输入序列的信息,而不仅仅是特定位置或特定元素的信息,来生成每个元素。自注意力机制的引入使得模型能够根据输入序列的全局信息进行决策。
多头注意力机制允许模型同时使用多个独立的注意力头来学习不同的表示子空间。在每个注意力头中,模型计算输入序列与一组学习到的权重(注意力权重)的加权和,每个头都有自己独特的权重参数,使得它可以关注输入序列的不同部分。多头机制的输出会被级联并通过线性变换,然后输入到下一层网络中。
使用多头注意力的优势在于,模型能够在不同的注意力头中学习到输入序列的不同特征和关系,提高了模型的表示能力。每个头都可以专注于处理输入序列的某个方面,从而更好地捕捉数据的复杂关系。此外,多头注意力还具有并行计算的优势,因为每个头可以独立计算,这大大提高了计算效率,使得模型能够处理更大规模的数据。
#### 前馈神经网络(Feed-Forward Neural Network)
在每个多头注意力机制之后,接着是一个前馈神经网络。前馈神经网络具备非线性变换的能力,可以帮助模型学习更复杂的模式和特征,增强了模型的表达能力。
在前馈神经网络中,每个神经元的输入通过加权求和后,经过一个非线性激活函数。这个非线性激活函数打破了神经元之间的线性关系,使得网络可以学习到非线性特征。这赋予了整个网络非线性建模的能力,使得它能够更好地拟合现实世界中的复杂问题。
#### 残差连接(Residual Connection)
在每个子层(多头自注意力机制和前馈神经网络)之后,都有一个残差连接(Residual Connection),将子层的输入与输出相加。这种结构简化了梯度的传播,有助于避免深层网络中的梯度消失或梯度爆炸问题。残差连接使得在训练深层网络时更容易优化,并且有助于更深的网络学习到有效的特征表示。
在深度神经网络中,特别是在很多层的网络中,训练时会遇到两个主要的梯度问题:梯度消失(Gradient Vanishing)和梯度爆炸(Gradient Explosion)。
> 梯度消失指的是在反向传播过程中,网络较深层的权重梯度变得非常小,甚至接近于零。当梯度非常小的时候,权重更新几乎没有效果,导致网络无法学习到有效的表示。
> 梯度爆炸指的是在反向传播过程中,网络较深层的权重梯度变得非常大,甚至趋于无穷。当梯度非常大时,权重更新可能变得非常大,导致网络权重值快速膨胀,无法稳定地收敛。
残差连接实际上通过一种跳跃传播(skip connections)的机制,将梯度直接从网络的深层传播到浅层。这使得在反向传播过程中,梯度在经过多个残差块时,不容易消失,而是可以更容易地流向浅层网络,从而保证了较浅层的权重得到有效的更新。
因此,残差连接的引入有效地缓解了梯度消失和爆炸问题,允许构建非常深的神经网络,使得这些网络可以更好地学习复杂的特征表示,从而在很多任务中取得了显著的性能提升。
#### 层归一化(Layer Normalization)
层归一化是一种正则化技术,它标准化每个子层的输出,使得其均值为0,方差为1。它确保了在每个层次上,数据的分布保持一致,从而更容易进行训练。
归一化操作,将每层的输出激活值控制在一个合适的范围内,从而在反向传播过程中保持了梯度的稳定性,减缓了梯度消失和梯度爆炸问题的发生。激活值过大会导致梯度爆炸,激活值过小会导致梯度消失。归一化之后的输出值会用于下一层的输入,这些输入保持在相对稳定的范围内,有助于加速训练的收敛过程。模型不需要花费太多的时间在调整各层之间的平衡上,能够更快地学到有效的特征表示。
归一化的操作还可以减少对初始权重的依赖。即使初始权重选择得不够好,归一化可以在训练过程中自适应地调整激活值,使得网络仍然能够顺利地学习到有效的特征表示。由于对超参数的选择不太敏感,这增加了网络的健壮性。即使一些超参数选择得不太好,归一化也能够在一定程度上保证网络的性能。
残差连接和层归一化是确保模型稳定训练的关键。它们有助于加速训练过程,提高模型的学习效果。
## 解码器
### 解码器输入 (Output Embedding)
解码器的输入和编码器输入一样,先进行嵌入操作,添加位置编码,再传入解码器。
### 多头自注意力机制(Multi-Head Self-Attention)
解码器中的多头自注意力机制类似于编码器,用于关注解码器自身的输入序列,确保输出的连贯性和正确性。
### 编码-解码注意力机制(Encoder-Decoder Attention)
这是解码器特有的部分。编码-解码注意力机制用于将解码器的当前位置与编码器的所有位置进行注意力计算,通过类似自注意力机制的过程得到权重,用于生成编码-解码关联信息。这样的操作使得解码器能够关注输入序列的不同位置,以便在生成每个 token 时考虑输入序列的全局信息。
### 前馈神经网络(Feed-Forward Neural Network)
解码器的每个位置上的向量通过一个全连接前馈神经网络进行处理,增加了模型的非线性建模能力。
### 残差连接和层归一化(Residual Connection and Layer Normalization)
与编码器相似,解码器的每个子层也包含残差连接和层归一化,以保持梯度的稳定性。残差连接通过跳跃传播将梯度从深层传播到浅层,有效地缓解了梯度消失和爆炸问题。层归一化操作确保了每个子层的输出保持稳定的分布,有助于训练过程的稳定性和加速收敛。
### 遮蔽注意力机制(Masked Attention Mechanism)
遮蔽注意力机制主要用于训练过程中的自回归生成任务。它限制了模型只关注当前位置之前的信息,而不会看到当前位置之后的信息。通过一个遮蔽矩阵,将当前位置之后的元素的注意力分数设为负无穷大(或一个足够小的负数),确保模型无法看到未来的信息,保持了生成过程的自回归性质。
> 自回归生成是指在生成序列数据时,每个元素都依赖于之前已生成的元素。这种方式确保了生成的文本或序列的连贯性,但生成速度相对较慢,因为每个token的生成都需要等待前面所有的token生成完毕。在训练时,遮蔽注意力机制确保了模型按照顺序逐个生成序列中的每个token。
> 非自回归生成(Non-Autoregressive Generation)与自回归相反,是指在生成序列数据时,所有元素可以并行生成,相互之间没有依赖关系。这种方式可以大幅提高生成速度,特别适用于需要快速响应的场景,如实时翻译。然而,非自回归生成通常无法保证生成的文本或序列的连贯性,因为生成的每个token都不依赖于前面的token。这种权衡在选择生成方法时需要根据具体应用场景和需求来决定。
## 输出
输出层通常包含两个主要部分:一个线性层(Linear Layer)和一个 Softmax 函数。线性层负责计算原始分数,Softmax 函数负责将这些分数转换为概率分布。
### 线性层(Linear Layer)
线性层是一个全连接层,它将模型的最后一个隐藏层的输出映射为预测的原始分数(logits)。这个映射是一个线性变换,即对每个类别都有一个权重,模型通过学习这些权重来调整每个类别的影响力。线性层的输出是未经归一化的原始分数,它可以是任意实数值,没有限制范围。
### Softmax 函数
Softmax 函数是一个常用的激活函数,通常用于多分类问题的神经网络输出层。它的作用是将神经网络的原始分数(logits)转换为概率分布。Softmax 函数对线性层的输出进行指数化(exponentiation),然后将指数化后的值归一化,使得所有类别的概率之和为1。这样,模型的输出就变成了一个概率分布,表示每个类别的预测概率。Softmax 函数的引入使得模型的输出更容易解释和使用,它将模型的输出转化为了类别概率,便于进行分类决策。
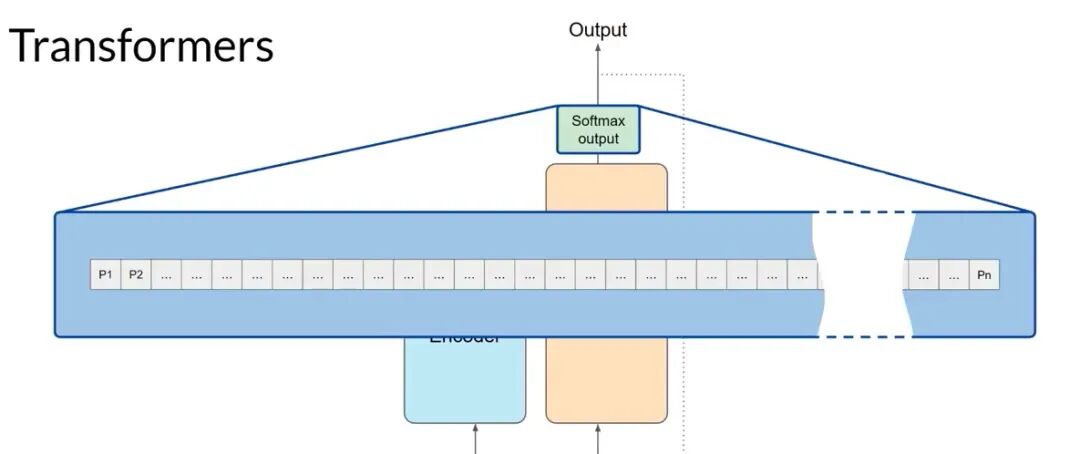
Softmax 归一化概率分布
#### 温度(Temperature)
温度是一个用于控制模型生成文本的随机性的参数。在 Softmax 函数计算概率分布时,温度参数(通常用τ表示)用于调整模型对于高概率和低概率标记的敏感程度。当温度参数较大时,Softmax 函数中指数运算的结果会变得平坦,使得所有标记的概率接近,即高概率标记和低概率标记的差异减小,增加了多样性。相反,当温度参数较小时,指数运算的结果会变得尖锐,使得高概率标记的概率增加,低概率标记的概率减小,增加了确定性。
得到下一个 token 的概率分布时,如果总是选择最大概率的 token,就会让整个生成文本固定化。为了提高生成文本的质量和多样性,产生了两种采样策略: Top-k采样和 TopP采样(Nucleus采样)。
#### 1\. Top-k采样:
在 Top-k 采样中,模型会根据预测的概率分布,保留排名前 k 个最高概率的标记,其余的概率为零。然后,模型会从这 k 个标记中进行均匀随机采样,选择一个作为下一个标记。然而,如果这些 token 的概率分布过于分散,可能会导致生成的文本缺乏连贯性。为了解决这个问题,引入了 Nucleus 采样。
#### 2\. TopP采样(Nucleus采样):
Nucleus 采样引入了一个概率阈值 p(通常是一个小于1的值,例如0.9或0.8),然后动态地选择 token,直到累计概率超过了 p。换句话说,它会选择概率分布中总概率累计到 p 的那些 token。这样,即便在 Top-p 中的 token 概率分布很分散,也能够保证生成的 token 集合相对紧凑,具有更好的连贯性。
Top-k 采样保留概率最高的 k 个 token,选择其中一个作为生成的 token。TopP 采样:选择概率分布中累计概率达到 p 的 token,这样可以保持生成 token 的多样性,同时防止生成过于随机和不连贯的文本。不同的任务和场景可能选择不同的采样策略。
# 总结
最后总结一下,Transformer 的架构主要包含输入、编码器、解码器、输出。输入信息通过 Embedding 处理输入编码器中,生成上下文表示,解码器接收自身的输入结合编码器的表示输出下一个 token 的概率分布,通过线性层和 Softmax 函数输出下一个 token。温度参数、Top-k 采样和 TopP 采样等技术则为生成文本增加了控制和灵活性,使得生成的文本更具多样性和可控性。