---
id: transformer-with-chatgpt
title: 使用 ChatGPT 进行 Transformer 架构复习
summary: 让 ChatGPT 担任面试官,通过一轮轮追问,复习 Transformer 并检验对架构细节的理解。
tags:
- AI
- Transformer
publishedAt: 2026-11-05T06:56:17.250Z
updatedAt: 2026-11-05T06:56:17.250Z
originalPublishedAt: 2023-11-09T10:25:00+08:00
wechatUrl: https://mp.weixin.qq.com/s/ApQB-outmuXRKk2OiZqqGw
url: https://wuyanji.datiaomao.com/articles/transformer-with-chatgpt/
markdownUrl: https://wuyanji.datiaomao.com/articles/transformer-with-chatgpt/index.md
---
# 在深入学习 Transformer 架构时,想到了之前有人用 ChatGPT 当面试官的方式学习,我也想来试验一下。果然这种方法极大地加深了我对 Transformer 技术细节的理解。以下是我与ChatGPT互动的精简版本,完整对话请参见最后的阅读原文。
> 我输入的 prompt 是:你是个教授transformer工作流程的老师,现在你要考验我对transformer架构的理解,我会请你出十个题目,我会进行解答,你根据我的解答给我评价,并展示你认为的答案。现在请你先出第一道题目,我回答之后你给我评价,并展示你认为的答案。等我说出下一道题的时候,你再继续出下一道题。
## ChatGPT 问答
### 一
解释Transformer架构中的自注意力机制(Self-Attention Mechanism)。请详细描述自注意力机制是如何工作的,以及它在Transformer中的作用。
标准答案:
在Transformer架构中,自注意力机制允许模型在处理输入序列时,同时关注输入序列的不同位置。具体来说,对于输入序列中的每个词(或标记),自注意力机制会计算与其他词的注意力分数。这些分数然后被用来加权计算一个加权和,形成编码器的输出。
在多头自注意力机制中,模型不仅使用一个注意力头,而是使用多个并行的注意力头。每个注意力头学习关注输入中的不同特征,因此,多头机制使得模型能够在不同层次上理解输入文本。多头机制的输出会被级联并线性变换,然后输入到下一层编码器或解码器中。
### 二
解释Transformer架构中的位置编码(Positional Encoding)。为什么在Transformer中需要使用位置编码?请详细描述位置编码的作用和它是如何被添加到输入嵌入中的。
标准答案:
在Transformer中,没有像循环神经网络(RNN)或卷积神经网络(CNN)中那样的显式顺序信息。为了将词的顺序信息引入模型,位置编码被添加到输入嵌入中。位置编码是一组特殊的向量,其维度与输入嵌入的维度相同。这些向量被设计为在不同位置上具有不同的数值,以便为词的顺序提供相对位置的信息。
位置编码的计算通常使用以下公式:
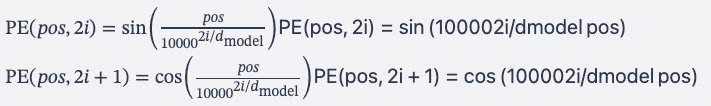
其中,pos 是位置,i 是维度的索引,dmodel 是输入嵌入的维度。这样,每个位置都会有一个唯一的位置编码,它包含了该位置的信息,帮助模型理解词的相对位置关系。
### 三
解释Transformer架构中的解码器(Decoder)。请详细描述解码器的结构和它在生成序列任务(如机器翻译)中的作用。提及解码器中的自注意力机制和编码-解码注意力机制(Encoder-Decoder Attention Mechanism)。
标准答案:
解码器是由多个相同结构的层叠解码器组成的。每个解码器层包含三个主要部分:
1. 多头注意力机制(Multi-Head Attention): 类似于编码器,解码器中的多头注意力机制允许模型在生成每个token时关注输入序列的不同部分,以便更好地捕捉上下文信息。
2. 编码解码注意力机制(Encoder-Decoder Attention):这一部分允许解码器关注输入序列的不同位置,这对于翻译等生成任务非常重要。它确保在生成输出序列的每个token时,模型可以根据输入序列的不同部分进行加权组合,从而获得全局信息。
3. 前馈神经网络(Feed-Forward Neural Network): 每个解码器层还包含一个前馈神经网络,它独立地作用于每个位置的输出。这个前馈网络包含两个线性变换和一个激活函数(通常是ReLU),用于对每个位置的特征进行非线性变换。
此外,每个子层都包含残差连接(Residual Connection)和层归一化(Layer Normalization),用于提高模型的训练稳定性和加速训练过程。
在机器翻译任务中,解码器接收到编码器的输出和目标序列的嵌入(或者在训练时使用了teacher forcing策略,即将目标序列的真实token作为输入),然后逐步生成目标序列的token,直到生成结束符或达到最大长度。编码解码注意力机制确保了解码器可以根据输入序列的全局信息来生成每个token,从而实现准确的翻译。
### 四
解释Transformer架构中的残差连接(Residual Connection)和层归一化(Layer Normalization)。这两个技术在Transformer中的作用是什么?请详细描述它们的应用场景和优势。
标准答案:
在Transformer架构中,残差连接和层归一化是非常重要的技术。
1. 残差连接(Residual Connection): 在每个子层(比如多头自注意力机制和前馈神经网络)的输入和输出之间设置了残差连接。这意味着子层的输出被加到了其输入上,即 Output=Input+Sublayer(Input)\\text{Output} = \\text{Input} + \\text{Sublayer}(\\text{Input})Output=Input+Sublayer(Input)。这种结构简化了梯度的传播,有助于避免深层网络中的梯度消失或梯度爆炸问题。残差连接使得在训练深层网络时更容易优化,并且有助于更深的网络学习到有效的特征表示。
2. 层归一化(Layer Normalization): 在每个子层的输出之后应用层归一化。层归一化是一种正则化技术,它标准化每个子层的输出,使得其均值为0,方差为1。这有助于缓解内部协变量偏移问题,提高了模型的训练稳定性。在Transformer中,层归一化被应用于每个子层的输入,确保了在每个层次上,数据的分布保持一致,从而更容易进行训练。
### 五
解释Transformer模型的训练过程。从输入数据到损失函数,描述Transformer模型是如何进行训练的。包括数据的预处理、模型的前向传播、损失函数的计算以及反向传播和参数更新等步骤。
标准答案:
1. 数据预处理: 输入文本数据首先需要被转换成模型可接受的格式,通常是将文本分词并转换为对应的词嵌入向量(Embedding)。这些向量化的数据成为模型的输入。
2. 前向传播(Forward Propagation): 向量化的数据被传入编码器(Encoder)中,经过多层的编码器结构,包括多头自注意力机制和前馈神经网络,模型学习输入序列的不同抽象层次特征。编码器的输出成为解码器(Decoder)的输入。
3. 损失函数的计算: 在训练中,需要定义一个损失函数(例如交叉熵损失函数),用于度量模型生成的文本与目标文本之间的差距。这个损失函数通常用生成文本的概率分布和目标文本的真实分布之间的差距来表示。
4. 反向传播和参数更新: 通过反向传播算法,模型计算损失函数对模型参数的梯度。然后,优化器(如Adam或SGD)使用这些梯度来更新模型的参数,使得损失函数的值最小化。这个过程是通过梯度下降来实现的,确保模型的预测结果更接近目标文本。
### 六
解释Transformer模型中的遮蔽注意力机制(Masked Attention Mechanism)。遮蔽注意力机制在训练中的哪些情况下被使用?它的作用是什么,以及它是如何实现的?请详细描述。
标准答案:遮蔽注意力机制用于自回归生成任务,如语言建模或文本生成。在这些任务中,模型需要逐个生成序列中的每个元素。遮蔽注意力机制的作用是限制模型在处理序列数据时只能关注当前位置之前的信息,而不能看到当前位置之后的信息。这样可以确保生成任务的顺序性,避免信息泄露。实现遮蔽注意力机制通常涉及到一个遮蔽矩阵,该矩阵是一个上三角矩阵,其对角线及以下的元素都设置为负无穷大(或一个极小的负数,以确保经过Softmax归一化后等于0)。在计算注意力分数时,遮蔽矩阵会使得当前位置之后的信息在Softmax操作后变为0,从而在注意力机制中被忽略。这种机制确保了在生成序列的过程中,模型只能依赖之前生成的标记,而不会依赖未来的标记,保持了自回归生成任务的顺序性。
### 七
解释Transformer模型的注意力集中(Attention Concentration)特性。在自注意力机制中,注意力集中是指什么?它在模型中的哪些情况下是有益的?请详细描述注意力集中特性的作用和优势。
标准答案:在自注意力机制中,每个位置的输出是由该位置与输入序列中所有位置的关联程度(注意力权重)加权得到的。因此,通过调整这些注意力权重,模型可以集中关注在输入序列的特定部分,从而实现注意力集中的效果。这种特性使得模型能够在处理长序列时更加有效,因为它可以选择性地关注与当前位置相关的重要信息,而忽略与当前任务无关的部分,从而提高了模型的效率和性能。
### 八
解释Transformer模型中的位置编码(Positional Encoding)和RNN(循环神经网络)的区别。为什么Transformer使用位置编码而不是RNN来处理序列信息?请详细描述它们各自的优势和劣势。
标准答案:在传统的循环神经网络(RNN)中,序列数据是按顺序逐个处理的,每个时间步的输入都依赖于上一个时间步的输出。RNN能够捕捉到序列数据中的顺序信息,但它们的计算是顺序的,导致难以并行化,因此在处理长序列时效率较低,而且容易受到梯度消失或梯度爆炸的问题。
相比之下,Transformer模型使用自注意力机制来处理序列数据,它不依赖于固定的顺序。然而,为了使模型能够理解输入序列中的相对位置信息,需要添加位置编码。位置编码的引入允许Transformer模型在没有固定顺序的情况下,仍然能够处理序列数据,并且能够捕捉到序列中的位置信息。
总的来说,Transformer模型的自注意力机制和位置编码的结合,使其能够处理长序列,并且在并行计算方面具有优势,相较于传统的RNN,更适合处理需要考虑长距离依赖关系的任务。而且,Transformer模型还更容易进行并行化训练,提高了训练效率。
### 九
解释Transformer模型中的多头注意力机制(Multi-Head Attention)。多头注意力机制是如何工作的?它在模型中的哪些情况下被使用?请详细描述多头注意力机制的作用和优势。
标准答案:
多头注意力机制允许模型同时使用多个独立的注意力头来学习不同的表示子空间。在每个注意力头中,模型会计算输入序列与一组学习到的权重(注意力权重)的加权和,每个头都有自己独特的权重参数,使得它可以关注输入序列的不同部分。多头机制的输出会被级联并通过线性变换,然后输入到下一层的网络中。
使用多头注意力的优势在于,模型能够在不同的注意力头中学习到输入序列的不同特征和关系,提高了模型的表示能力。每个头都可以专注于处理输入序列的某个方面,从而更好地捕捉数据的复杂关系。此外,多头注意力还具有并行计算的优势,因为每个头可以独立计算,这大大提高了计算效率,使得模型能够处理更大规模的数据。
### 十
解释Transformer模型中的自回归生成(Autoregressive Generation)和非自回归生成(Non-Autoregressive Generation)的区别。这两种生成方式在什么情况下分别被使用?请详细描述它们的优势和限制。
标准答案:
自回归生成(Autoregressive Generation)是指在生成序列数据时,每个元素都依赖于之前已生成的元素。在自回归生成中,模型按照顺序逐个生成序列中的每个token。这种方式确保了生成的文本或序列的连贯性,但生成速度相对较慢,因为每个token的生成都需要等待前面所有的token生成完毕。
非自回归生成(Non-Autoregressive Generation),与自回归相反,是指在生成序列数据时,所有元素可以并行生成,相互之间没有依赖关系。这种方式可以大幅提高生成速度,特别适用于需要快速响应的场景,如实时翻译。然而,非自回归生成通常无法保证生成的文本或序列的连贯性,因为生成的每个token都不依赖于前面的token。
自回归生成保证了生成文本的连贯性,但速度较慢。非自回归生成速度较快,但可能会牺牲文本的连贯性。选择使用哪种方式通常取决于具体的应用场景,需要权衡生成速度和生成结果的质量。
### 十一
Transformer模型中的哪些部分使其具有可解释性(interpretability)?解释性在自然语言处理任务中为什么很重要?请详细描述。
标准答案:
在Transformer模型中,自注意力机制(Self-Attention Mechanism)赋予了模型一定的可解释性。在自注意力中,模型在计算每个位置的输出时,会考虑到其他所有位置的信息,并为每个位置分配一个权重,表示该位置与其他位置的关联程度。这些权重矩阵可以用来解释模型在生成预测时,对输入序列中的哪些部分进行了关注。通过分析这些权重,我们可以了解到在特定任务中,模型对输入序列的哪些部分进行了较强的关注,从而帮助理解模型的决策过程。
在自然语言处理任务中,可解释性非常重要。它能够帮助我们理解模型的预测,找出模型在处理输入时的特定模式和关键特征。在很多实际应用中,比如医疗诊断、法律领域的文本分析等,解释模型的决策过程对于人类决策者的信任和决策的合理性非常关键。可解释性还有助于调试模型、发现数据集中的问题,以及提高模型的鲁棒性。
因此,自注意力机制在提供了一种可解释性的同时,也使得Transformer模型在自然语言处理任务中得到了广泛的应用。
# 结语
不得不感叹,利用 ChatGPT 的强大能力确实能够显著加速新领域的学习进程。它能提供及时、专业的反馈,仅需要你提出问题。这种交互式的学习方式而且非常适合快节奏的现代学习需求。