---
id: verifiable-agent-loop
title: Agent 如何实现可验证的自主开发闭环?
summary: 从一个没有真正保存的收藏按钮出发,拆解需求验收、运行反馈和交付证据。
tags:
- AI
- 软件工程
publishedAt: 2026-11-05T06:56:17.250Z
updatedAt: 2026-11-05T06:56:17.250Z
writtenAt: 2026-10-13
originalPublishedAt: 2026-10-14T09:06:00+08:00
wechatUrl: https://mp.weixin.qq.com/s/Ta-zSCMbxR_SOVS1t5TVSg
url: https://wuyanji.datiaomao.com/articles/verifiable-agent-loop/
markdownUrl: https://wuyanji.datiaomao.com/articles/verifiable-agent-loop/index.md
---
QUOTE
写代码的能力不会自动变成交付能力。
从五个核心难题,看 Coding Agent 如何实现可验证的自主开发闭环
假设你让 AI 给项目增加一个收藏功能。
Agent 启动,几分钟后,它告诉你:完成了,还附上截图。
页面上出现了收藏按钮,点击后图标变了,提示也弹出来了。但当你刷新页面,再打开收藏列表时,刚才收藏的内容不见了。
问题并不复杂:它更新了界面,却没有真正保存数据。
通常,我们会得出一个结论:AI 写的代码还得认真检查。
但如果目标不是让 AI 辅助写代码,而是让 Agent 自主推进开发任务,这个结论还不够。
更值得追问的是:为什么这个问题必须由我来发现?
没有我的检查,它能不能自己发现?发现之后,能不能自己修复?修复之后,又凭什么判断任务已经完成?
我的思考是:
Agent 自主开发的关键突破,不是让 AI 更会写代码,而是建立一个能够把需求转换为验收条件、把运行结果转换为修复反馈、把验证证据转换为完成判定的系统。
这不是说模型能力不重要,而是说,写代码的能力不会自动变成交付能力。两者之间,还缺少一套反馈与裁决机制。
这套机制要完成三次转换:定义完成、驱动完成、证明完成。 展开来说,这里面会包含五个难题。
1
Agent 怎么知道自己真正要完成什么?
2
Agent 怎么证明自己真的做对了?
3
验证失败之后,Agent 怎么知道下一步做什么?
4
Agent 什么时候应该停止?
5
怎么证明这个 Agent Loop 本身可靠?
下面始终使用同一个例子:一个可以浏览文章、收藏文章、查看收藏列表的 Web 应用。前端、接口、数据库都很普通,重点不在技术选型,而在 Agent 怎样完成这件事。
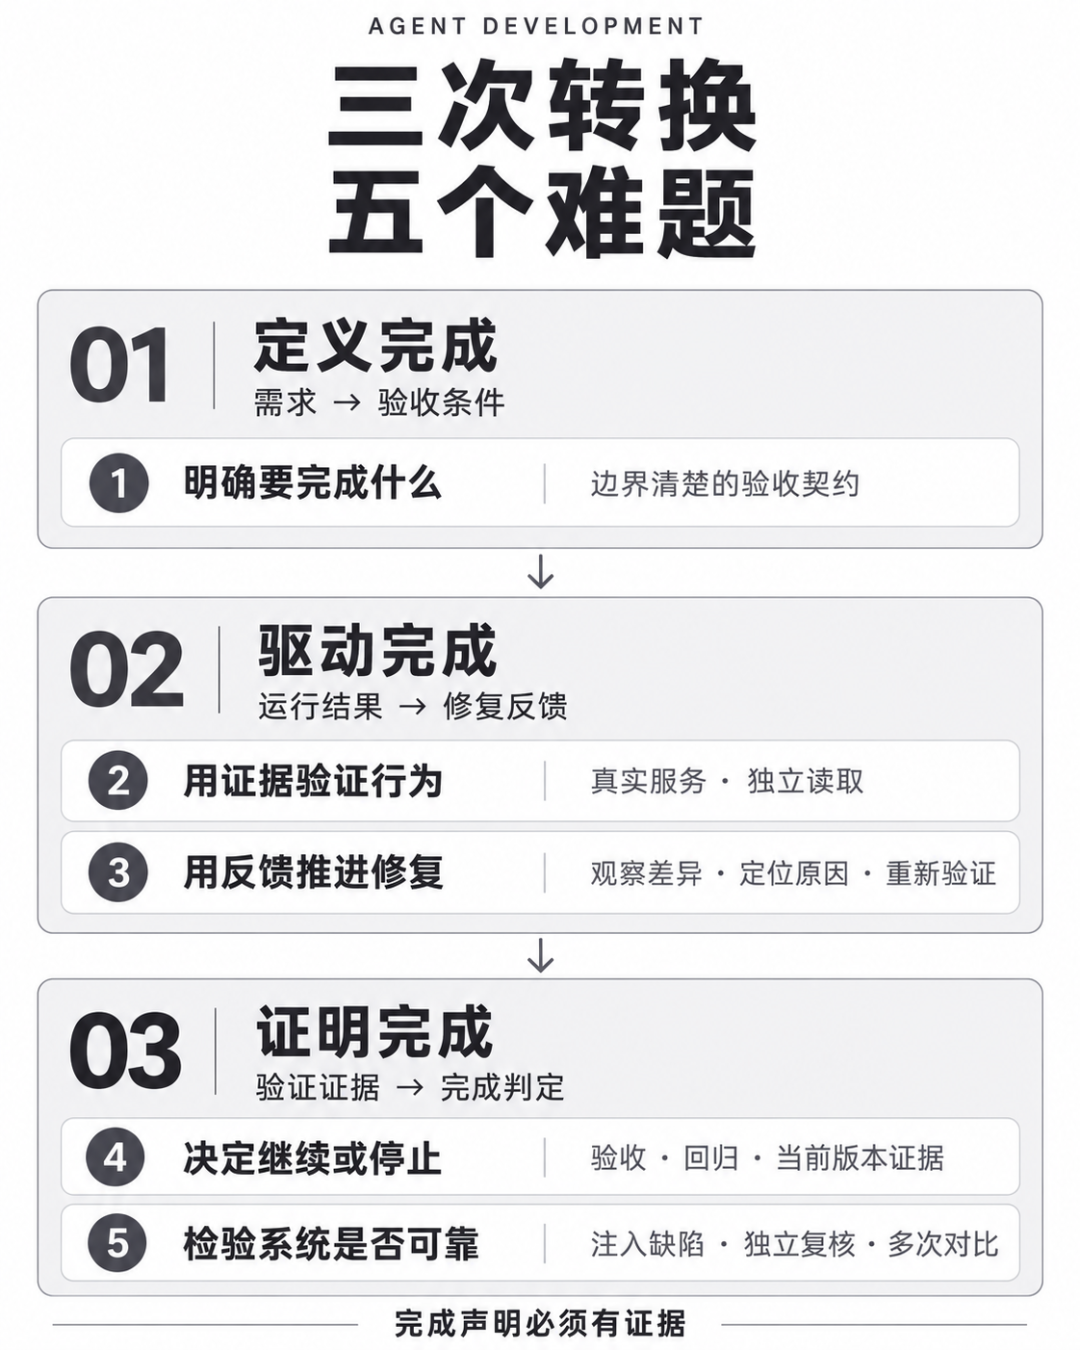
— 图一:全文总览 · 三次转换,连接五个难题
01
ACCEPTANCE
### 定义完成:把需求转换为验收条件
难题 1:Agent 怎么知道自己真正要完成什么?
“增加收藏功能”对人来说容易理解,却不足以作为自动化系统的完整目标。
收藏要保存在哪里?刷新页面后是否保留?能不能取消?保存失败时应该显示什么?
这些问题不明确,Agent 就只能自行补全需求。它的理解,不等于双方的约定。
目标不清楚,执行再认真也无法可靠验收。
因此,自主开发要先把需求转成可观察、可判断的验收条件,再开始写代码。
以收藏功能为例,先约定收藏关系保存在服务端数据库中。最小验收条件可以是:
收藏成功
:点击后,服务端保存当前用户与文章的收藏关系。
再次读取
:刷新页面、重新进入收藏列表后,仍能读到这条收藏。
取消收藏
:取消后,界面与服务端状态一致,再次读取时收藏不再出现。
保存失败
:接口失败时明确提示,不能将未保存的状态显示为成功。
这些条件组成“验收契约”,明确任务的最低要求。
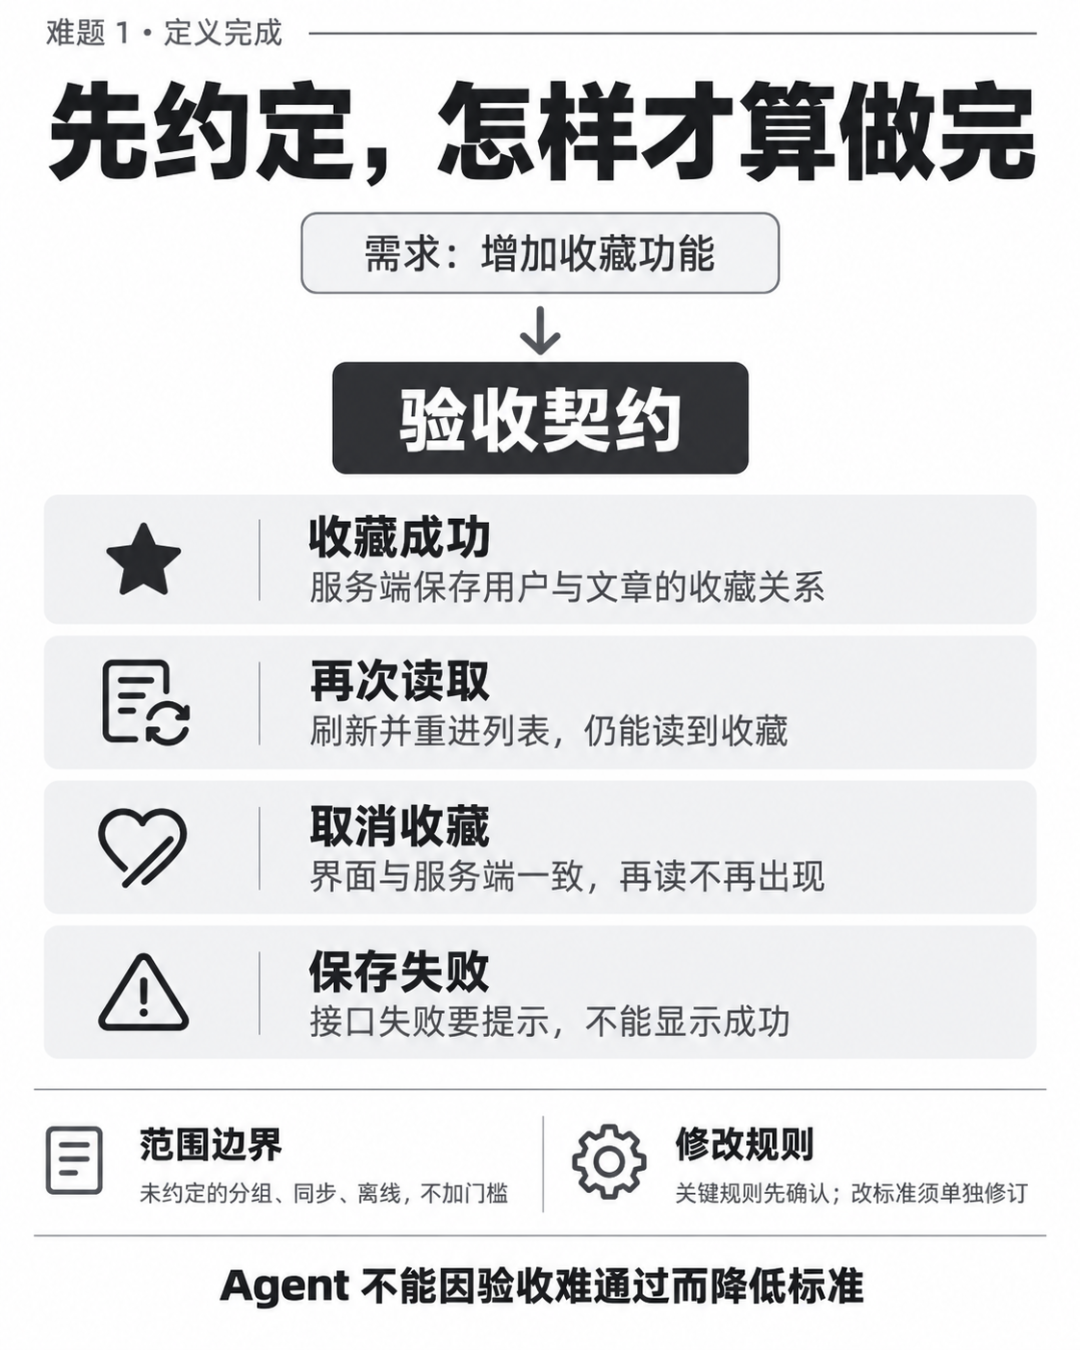
— 图二:难题一 · 先约定怎样才算完成
但“功能完整”不等于做完所有能想到的功能。
收藏未必需要分组、跨设备同步或离线操作。未约定的功能,不应由 Agent 擅自加入完成门槛。
自治需要的不是无限完整的需求,而是边界清楚的需求。
这份契约由谁制定?
Agent 可以补充遗漏的场景,但关键业务规则仍需在开发前确认。确认后,实现 Agent 不能因验收难以通过而自行降低标准。
否则,它既答题,又能改题、给自己打分,所谓闭环仍只是在重复自己的判断。
验收标准也可能有错,此时应提出证据,单独修订,不能把改标准与修代码混在一起。
这一层明确的是系统目标:
观点
需求不只用于指导 Agent 写什么,还要能判断它是否做完。
有了目标,才能开始验证。
02
FEEDBACK
### 驱动完成:把运行结果转换为修复反馈
难题 2:Agent 怎么证明自己真的做对了?
最直接的办法是让它写测试。
但测试检查什么,比有没有测试更重要。
如果实现只切换收藏图标,测试也只检查图标变化,测试就会通过,持久化缺陷却依然存在。
下面的伪代码就只检查了图标状态:
TS
test('favorite button toggles', async ({ page }) => {
await page.goto('/articles/1');
await page.getByTestId('favorite-button').click();
await expect(page.getByTestId('favorite-button'))
.toHaveAttribute('aria-pressed', 'true');
});
它无法证明请求已发出、服务端已保存,以及下次还能读到数据。
问题不在执行是否认真,而在于验证依据没有覆盖真实目标。
让 Agent 再检查一遍也不能自动补上缺口:它可能沿用写代码时的理解,仍然发现不了问题。
因此,完成声明需要独立的执行证据支持。
验证收藏功能时,可以用浏览器自动化工具操作页面,由真实测试服务处理请求,再检查重新读取的结果,并用接口与存储检查补充证据。
但刷新后收藏还在,不一定说明服务端已完成持久化。
本地缓存也可能产生同样的结果。契约若要求服务端保存,就要绕开前端缓存,经服务端独立读取;必要时检查存储状态,或重启测试服务后再读一次。
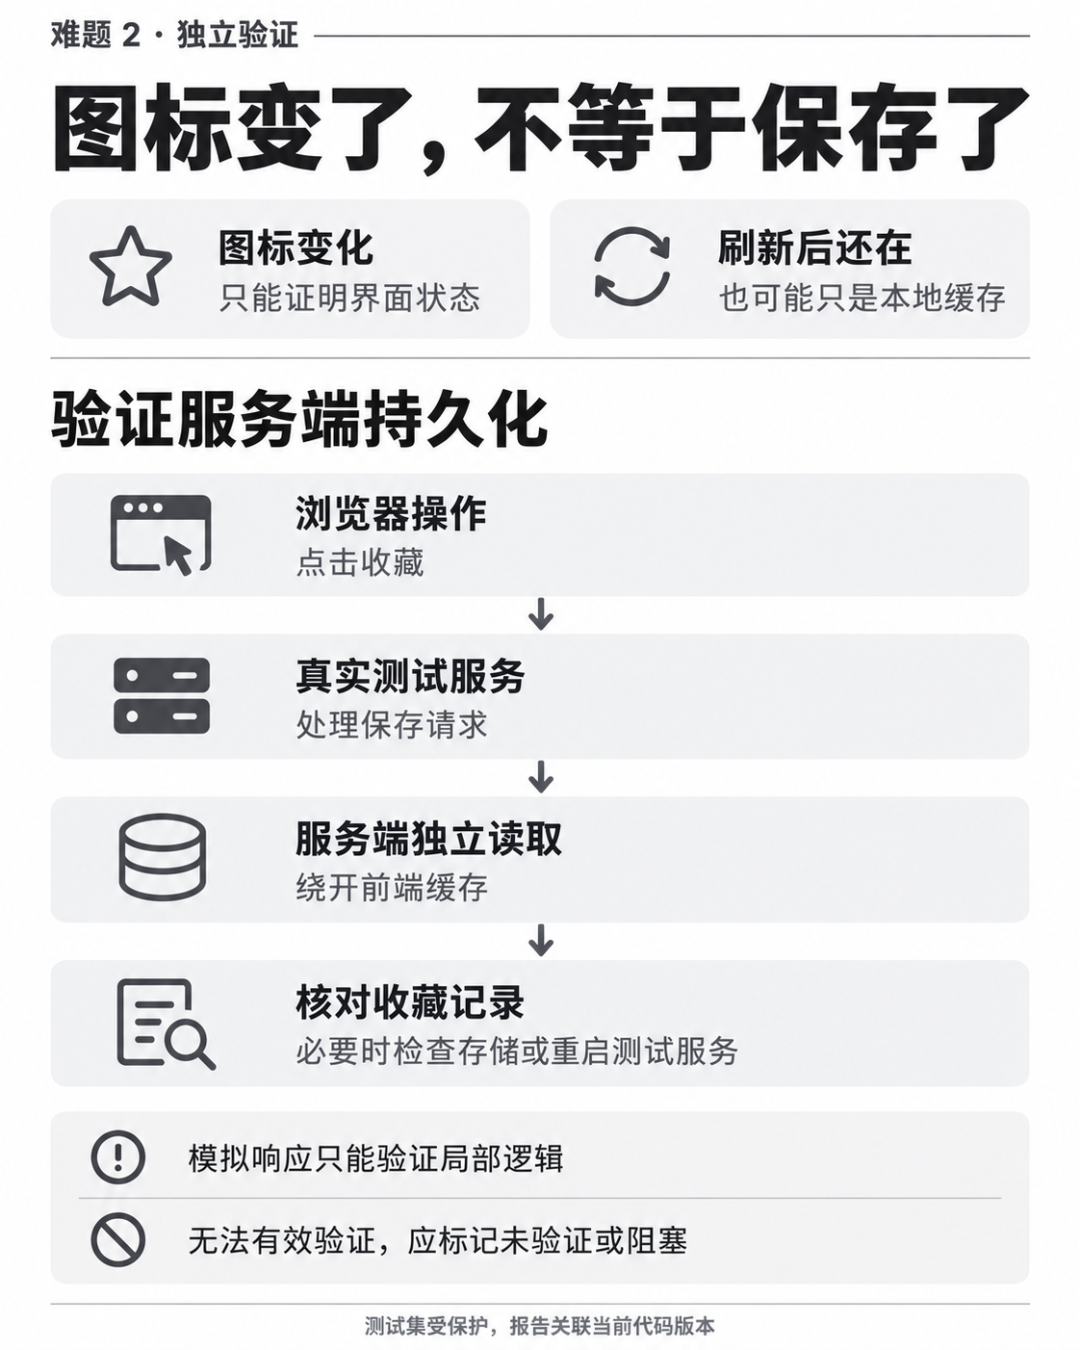
— 图三:难题二 · 从界面现象到持久化证据
这些检查是为了让证据对应验收条件。
模拟成功响应可以验证局部逻辑,却不能证明真实接口已保存数据:被模拟掉的行为仍需实际验证。
独立验证不一定需要另一个 Agent。
受保护的验收测试集、可重复运行的测试环境,以及关联当前代码版本的执行报告,就可以承担主要验证职责。
关键在于明确:谁能修改标准,谁执行检查,谁宣布通过。
实现 Agent 可以修改业务代码、补充辅助测试,但不能随意删除必需验收项,或把报告中的失败改成通过。即使增加审查 Agent,两者若共享错误假设,也未必能发现遗漏。
验证器还要区分:功能不符合要求,还是尚未得到有效验证。
服务未启动、测试账号无法登录、旧数据残留,都可能让结果失真。无法完成检查时,应标记为“未验证”或“阻塞”,不能默认成功。
因此,重点在于:
让实际运行的行为接受检验,让完成声明依赖证据,而不是让证据依赖完成声明。
难题 3:验证失败之后,Agent 怎么知道下一步做什么?
到这里,检查已经自动化,开发还没有闭环。
测试失败后,谁分析问题、决定下一步并重新执行?
如果每次都要开发者复制日志,再让 AI 修改,反馈链条就仍需人来处理。
Loop 需要把验证结果直接转成下一轮开发的输入。
输入不能只有“失败了,再试一次”,至少要包含失败的验收项、触发步骤、预期与实际结果,以及证据位置。
一份简化的失败反馈可以这样写:
JS
const feedback = {
testId: "AC-02",
status: "FAIL",
steps: \[
"Favorite article A",
"Reload page",
"Open favorites"
\],
expected: \["article A"\],
actual: \[\],
saveRequest: { status: 500 },
serverRecordExists: false,
evidence: \[
"network.log",
"screenshot.png"
\]
};
接口返回 500 只是观察到的事实,不能据此断定数据库代码有错,具体原因仍需定位。
但这份反馈已将“收藏好像不对”缩小到一条可调查的失败路径。
接下来,Agent 形成假设、检查证据、修改相关代码,再次验证。假设是否成立,由新的验证结果判断。
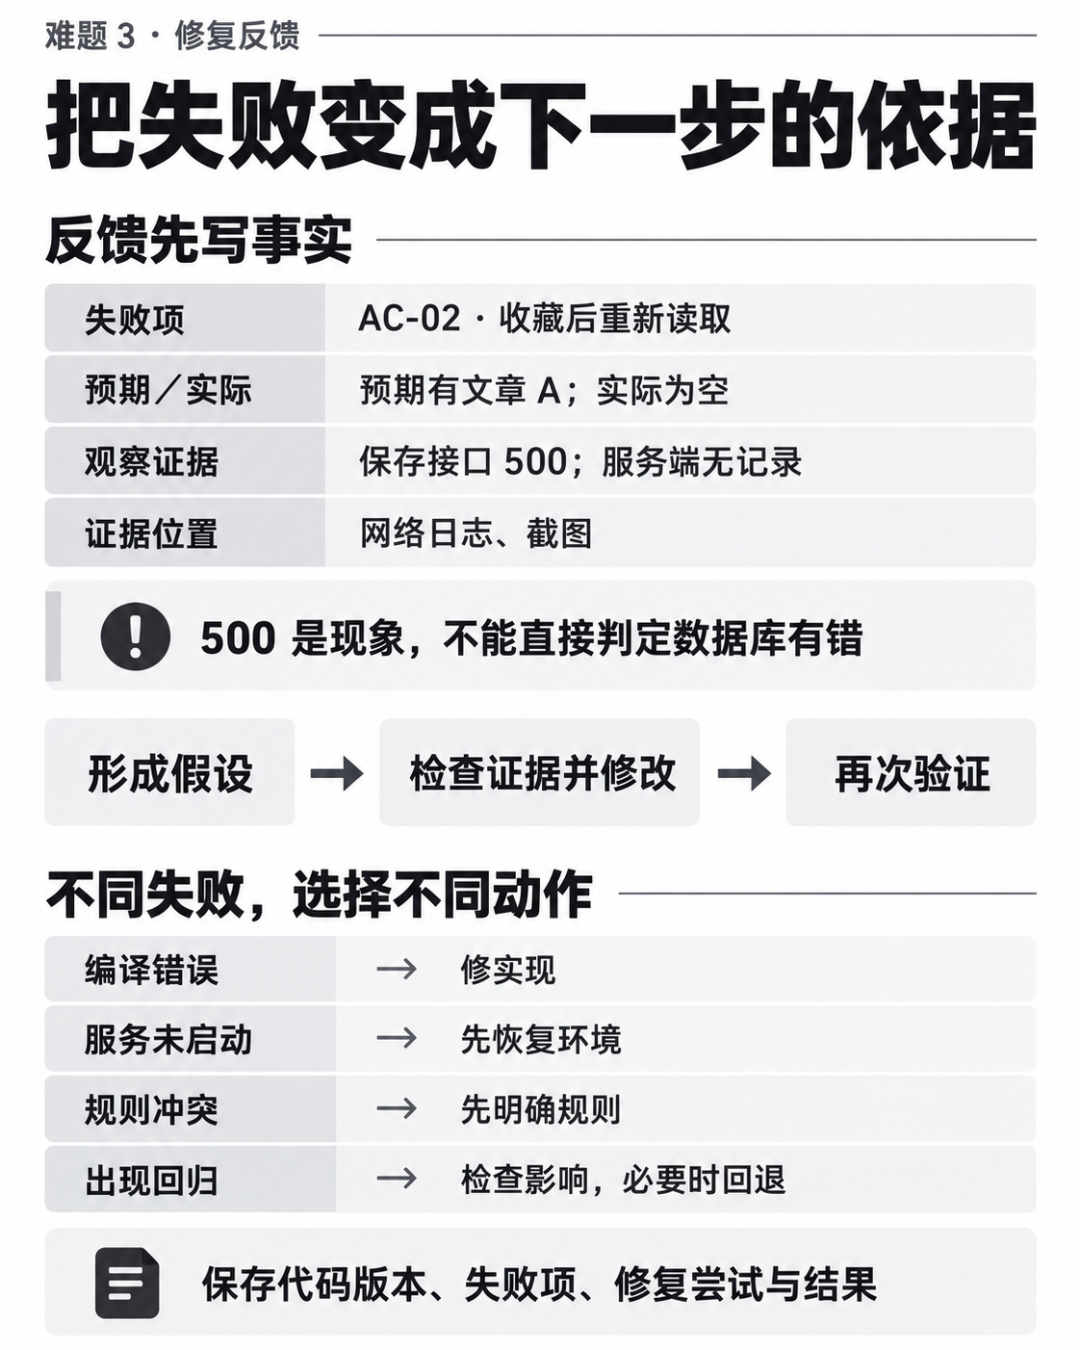
— 图四:难题三 · 让失败反馈指导下一步
修复反馈应减少下一步行动的不确定性,而非替 Agent 下结论。
失败也不总要靠修改业务代码解决。
编译错误需要修实现;测试服务未启动,要先恢复环境;验收规则冲突,要先明确规则;修复收藏却破坏了文章列表,则要检查变更影响,必要时回退。
如果这些情况都只得到“请继续修复”的指令,Agent 就可能为绕过环境问题,改坏原本正确的代码。
因此,Loop 的每一轮都需要判断:
实现 → 执行验证 → 观察差异 → 选择修复动作 → 再次验证。
每一轮都要提供新证据,或对已有假设作出可检验的改变。反复改动、声称“应该修好了”,不代表问题正在解决。
为了能恢复执行,当前代码版本、未通过的验收项、尝试过的修复及其验证结果,都要记录下来,不能只留在对话里。
否则,更换上下文后,Agent 可能重复失败的尝试。
Agent 自治首先是反馈控制问题:设定目标、观察差异,再据此调整行动。
但每轮修改不保证更接近目标,修复也可能引入新缺陷。因此,持续运行不能替代回归检查、回退和停滞检测。
验证在开发中的作用也随之改变:
验证不再只是开发结束后的检查,而是驱动开发继续进行的反馈机制。
03
DECISION
### 证明完成:把验证证据转换为完成判定
难题 4:Agent 什么时候应该停止?
假设 Agent 修复了保存接口,原先失败的测试通过了。
可以宣布完成了吗?
单凭这一项还不够。
取消收藏验证了吗?保存失败会不会仍显示成功?文章列表有没有受影响?报告对应当前代码,还是修改前的版本?
测试通过是一项证据,任务完成则需要综合判定。
这次收藏任务的完成条件可归为三项:必需验收项全部通过,约定范围内的回归检查通过,验证证据有效且对应当前版本。
必需测试被跳过、未执行或运行中断,都不能算通过。
测试通过后若又修改了代码,旧报告就不能直接证明新版本合格,需要按改动影响重新验证。
这里的“完成”是指:当前实现在约定范围内满足交付条件。 它不保证所有未知场景都没问题,也不自动意味着可以发布到生产环境。
可控的 Agent Loop 至少要区分四种结果:
|
状态
|
含义
|
| --- | --- |
| PASS |
约定的完成条件满足,可以进入下一交付环节
|
| FAIL |
有明确失败项,预算与条件允许时继续修复
|
| BLOCKED |
环境、权限或依赖阻止了有效验证
|
| REVIEW\_REQUIRED |
规则冲突、持续无进展或预算耗尽,需要接管
|
FAIL 不必立即结束循环;其余结果需按各自的交接规则退出当前自动修复流程。
控制逻辑可以写成以下伪代码:
TS
async function runAgentLoop(maxRepairs = 5) {
const history = \[\];
for (let i = 0; i <= maxRepairs; i++) {
const report = await verifier.run();
if (report.blocked) {
return { status: "BLOCKED", report };
}
if (report.acceptancePassed &&
report.regressionPassed &&
report.evidenceValid) {
return { status: "PASS", report };
}
if (report.contractConflict ||
isStalled(history, report) ||
i === maxRepairs) {
return { status: "REVIEW\_REQUIRED", report };
}
history.push(report);
await agent.repair({
failures: report.failures,
evidence: report.evidence
});
}
}
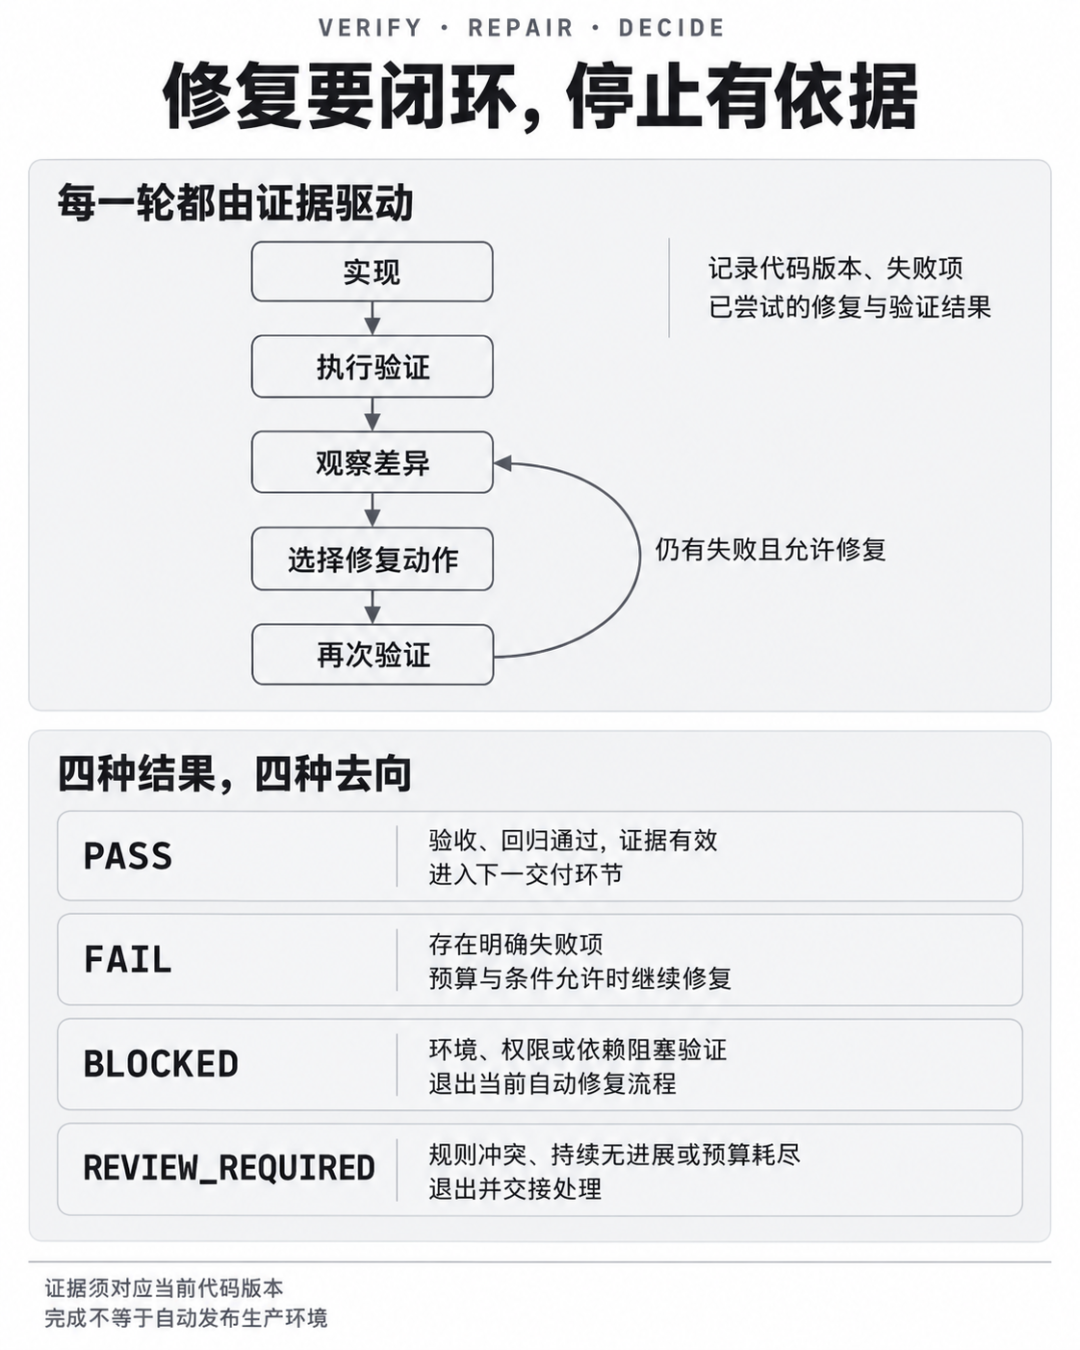
— 图五:难题四 · 修复要闭环,停止有依据
代码体现了三者的职责:Agent 修改实现,验证器产生证据,控制规则决定继续还是停止。
无人值守也需要停止条件。环境无法验证,或同一问题反复出现时,应明确交接,而不是继续消耗调用次数。
报告“未完成”并说明卡在哪里,也是有效结果。
难题 5:怎么证明这个 Agent Loop 本身可靠?
前四个问题解决后,方案似乎已经完整。
但还要问:凭什么相信这套系统?
Agent 运行三轮后输出 PASS,只能说明流程进入了通过分支,不能单凭这一点证明判定可靠。
验证器可能漏检,验收契约可能不完整,修复也可能只碰巧通过已知测试。
因此,除了代码,还要检验验证与修复系统本身。
可以故意注入缺陷,观察系统的反应。
仍以收藏功能为例:删掉保存逻辑却让界面显示成功;取消收藏时只切换图标;让保存接口返回错误;再引入导致文章列表回归的修改。
每种缺陷都应从干净、可恢复的基线开始测试,并分别观察:验证器能否发现问题,Agent 能否在预算内修复。
修复后,用实现 Agent 不能随意改写的验收与回归检查复核。可以保留未向它展示的测试场景,但必须来自已约定的需求,不能事后增加要求。
据此,可以衡量四个指标。
缺陷检出率: 注入的有效缺陷中,有多少被自动发现?它衡量验证器发现问题的能力。
自动修复成功率: 需要修复的有效任务中,有多少在约定预算内通过独立验收与回归检查?它衡量系统发现问题后的完成能力。
假通过率: 系统判定为 PASS 的任务中,有多少未通过独立复核?它衡量完成声明的可信度。
人工干预率: 有多少任务需要人补充信息、判断或接手?它衡量自动化替代持续监督的程度。
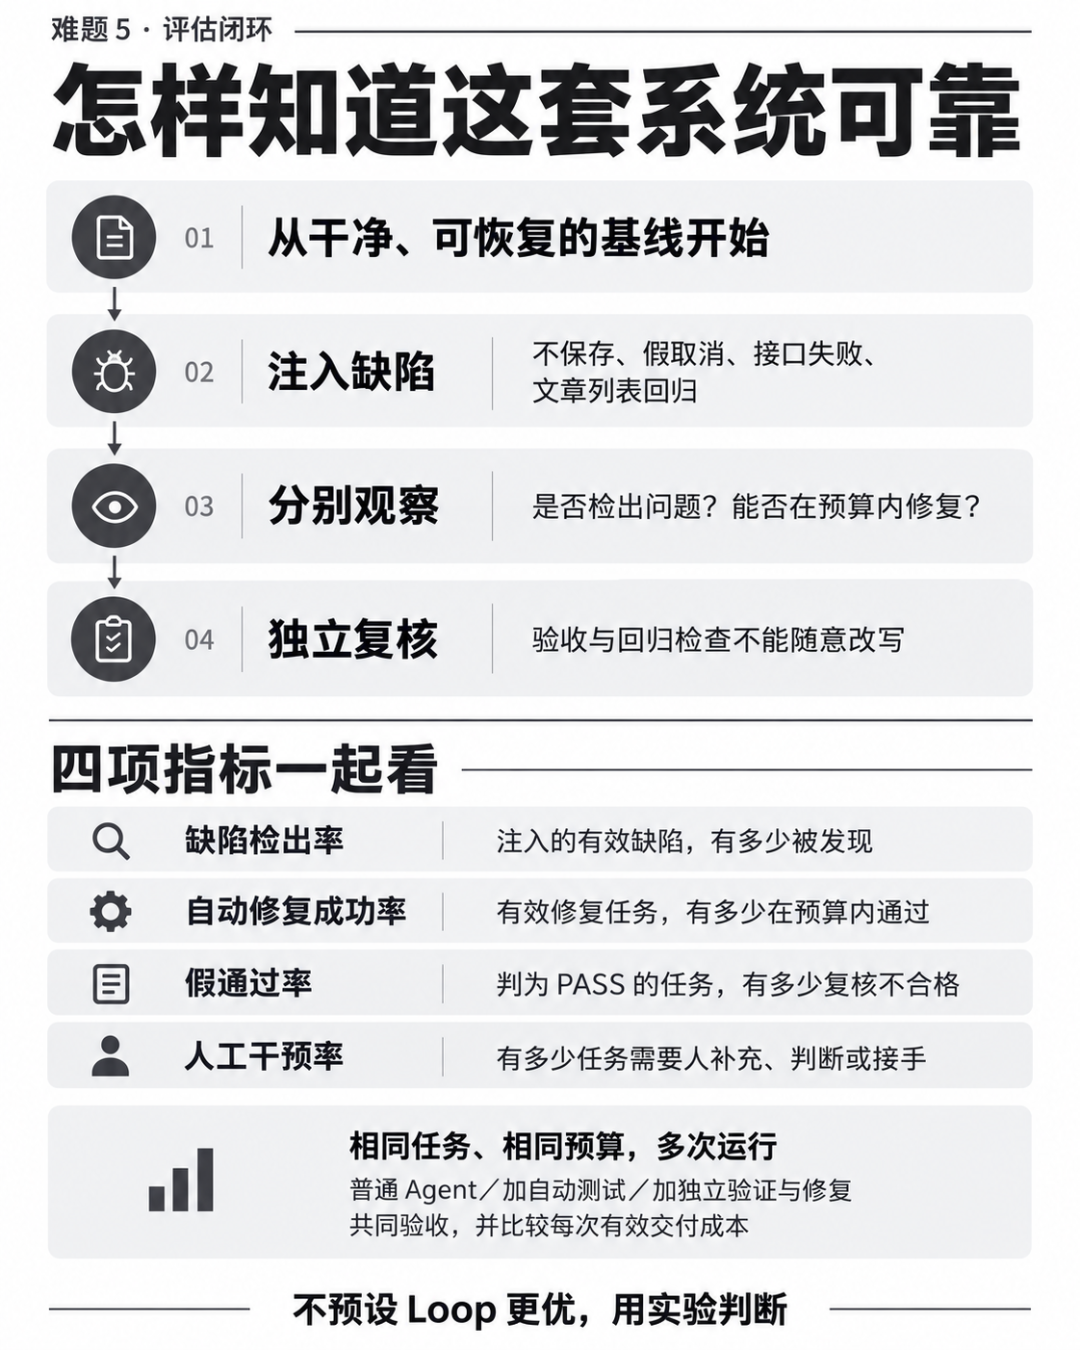
— 图六:难题五 · 用实验检验闭环是否可靠
这些指标需要结合来看。
总是要求人工处理的系统,可能很少假通过,却缺乏自主完成能力;频繁宣布成功的系统,可能自动完成率很高,交付却不可信。
因此,要同时考察完成率、假通过率、干预率,以及每次有效交付的成本。
要判断收益是否来自闭环,可以在相同任务和预算下对比:普通 Agent 开发、Agent 加自动测试、Agent 加独立验证和自动修复 Loop。
三种方式都由同一套独立验收评判,并通过多次运行观察差异,不能只展示一次成功演示。
实验不预设 Loop 更优:它可能减少人工介入,也可能因反馈质量不足而反复修错。这些差异都应通过实验呈现。
观点
我们真正需要评估的,不是 Agent 能运行多久,而是它能否发现真实错误、恢复正确行为,并减少错误的完成判定。
∞
THE END
### 自治不是去掉人,而是只让人承担重要的判断
回到最初那个收藏按钮。
在人工监督的开发过程中,开发者会顺手刷新页面,打开收藏列表,看一眼请求,再试试取消操作。
这些动作看起来琐碎,却同时承担着几种职责:补全需求、验证行为、定位失败,以及判断是否可以结束。
当我们希望 Agent 自己运行时,不能只把人从流程里拿掉,却把这些职责一起删掉。
人的持续监督,要被明确的目标、真实的观察、可操作的反馈和可执行的判定机制接替。
五个难题,其实就在填补这五个位置:知道要做什么,知道是否做对,知道错了怎么推进,知道什么时候停止,以及知道整套机制是否值得信任。
人仍然需要决定关键目标、确认有歧义的规则,并处理超出自动化边界的选择。但人不必再成为每一次“发现问题 → 复制日志 → 要求重试”之间的连接器。
理想的结果,不是 AI 更自信地说“收藏功能已经完成”。
而是系统自动执行收藏、重新读取数据,发现记录没有保存;把失败路径交给 Agent;Agent 修复后再次接受验证;最后拿着与当前版本对应的证据,进入交付环节,或者明确交接尚未解决的问题。
因此,回到本文最开始的判断:
观点
Agent 自主开发的关键突破,不是让 AI 更会写代码,而是建立一个能够把需求转换为验收条件、把运行结果转换为修复反馈、把验证证据转换为完成判定的系统。
真正值得追求的,不是一个永远运行下去的 Agent。
而是一个不需要你逐步盯着,也能依据证据继续推进,并在该停止时停止的开发系统。
END
我是 Yakir,一名移动端原生开发工程师,擅长将想法落地为移动端应用。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。